fsQCA Studio:零基础也能做出规范的模糊集定性比较分析
fsQCA
Studio:零基础也能做出规范的模糊集定性比较分析
副标题候选:一个 R Shiny
工作台,把校准、必要性、真值表、组态、稳健性、可复现报告全串起来(附真实运行结果)
一句话:给第一次做
fsQCA(模糊集定性比较分析)的人用的软件——不写代码、不查手册,15
分钟从一份 CSV 走到能直接放进论文的组态表;顺便把现有软件缺的 RoN、PRI
诊断、稳健性检验和可复现脚本全都补上。
先看一次真实的运行结果
数据:120 家制造企业的数字化转型问卷(7 点量表,5
个前因条件)。 模型:校准(理论锚点 2 / 4 / 6)→ 真值表(一致性
0.80、PRI 0.70、频数 1)→ 中间解。
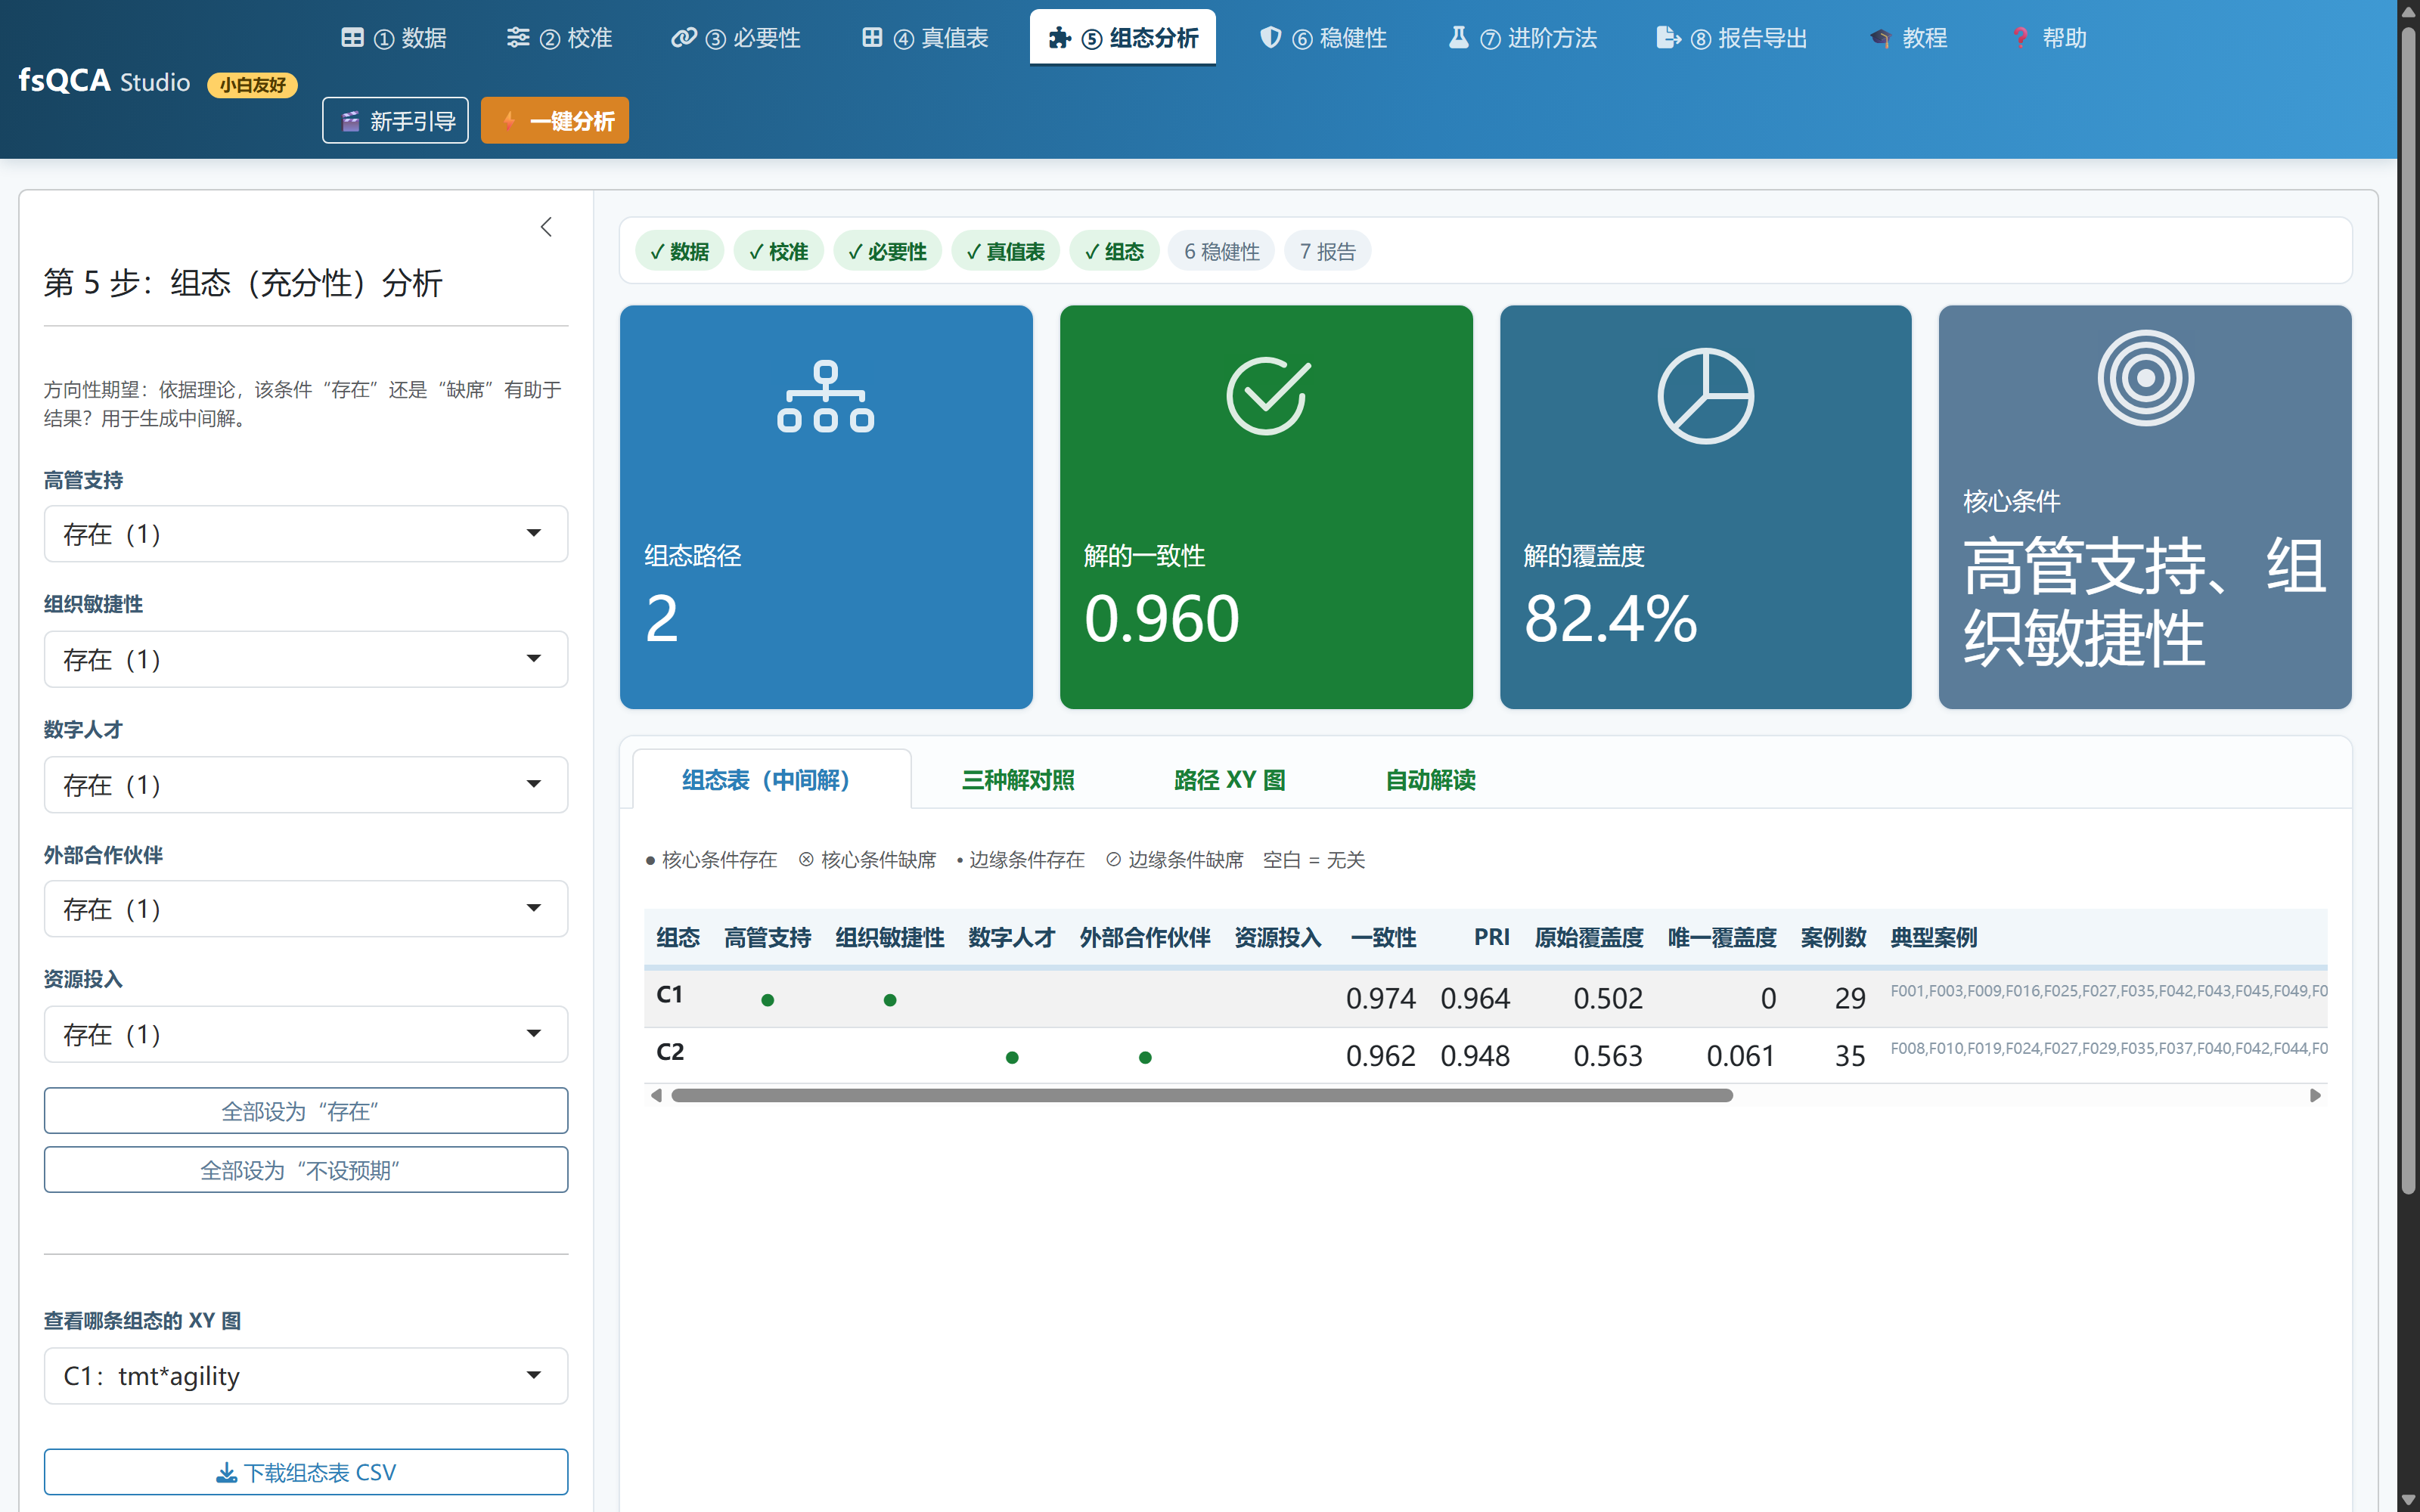
跑出来的组态表是这样(软件原始截图,不是我画的):
组态
高管支持
组织敏捷性
数字人才
外部伙伴
资源投入
一致性
PRI
原始覆盖度
唯一覆盖度
案例数
C1
●
●
0.974
0.964
0.502
0.000
...
TVP-VAR-SV:时变参数 VAR 模型的完整 Python 实现
TVP-VAR-SV:时变参数
VAR 模型的完整 Python 实现
一句话:把宏观与金融实证里最常用的
TVP-VAR-SV 模型——时变参数 +
随机波动率——做成一套开箱即用的 Python 实现:完整的贝叶斯
MCMC、时变溢出分解、脉冲响应,再配一个打开浏览器就能用的界面。
你大概遇到过这些
变量之间的传导关系,危机前后明显不一样,可模型里只有一个固定系数;
政策冲击的效果,十年前和现在不是一回事;
残差波动有明显的聚集,模型却假设它是常数。
这些正是 TVP-VAR-SV
要回答的问题——它在三个层次上都允许参数随时间变化。
但真动手时门槛不低:Gibbs 抽样要自己搭;Carter-Kohn
前向滤波后向抽样要自己写;
随机波动率不是线性高斯,得用混合正态去近似;链一旦不收敛,还很难定位原因。
好不容易跑通,时变溢出、脉冲响应、对冲比率又要自己从头算……
结果 80% 的时间花在实现上,只有 20% 在做研究。
导入数据后立刻给出样本量、序列数与区间,11
个商品价格序列一览
模型:三处时变性
TVP- ...
做空间计量,别再和 R 代码死磕了
做空间计量,别再和 R
代码死磕了
一句话:把
spatialreg、sphet、splm、spsur
里最主流的空间计量模型,全塞进一个双击就能用的 Windows
软件里——从数据、权重、检验、建模,到稳健性验证和出报告,一个界面走完。*
你是不是也这样过?
调 lagsarlm 的参数调了一下午,报错是
'a' is computationally singular; 面板数据一跑
spml 就提示
unbalanced panels,查了半天是列顺序的问题; 好不容易把
spsur 的 SUR-SARAR
跑通,又要自己算直接效应、间接效应、总效应…… 最后发现:80%
的时间花在跟代码和环境较劲,只有 20% 在做研究。
如果有这么一个软件——模型点一下就跑、结果自动成表、还能一键出报告——你愿不愿意试试?
软件全貌
它长这样:三个步骤走完全流程
准备数据与权重 → 检验并建模 → 比较出报告
首页三张卡片,就是完整的研究路径,每一步都能一键跳转。
三步流程
内置 9 套示例数据,哥伦布犯罪率、美 ...
综合评价模型复现介绍:基于偏联系数-证据理论耦合的膨胀土胀缩性动态评价
综合评价模型复现介绍:基于偏联系数-证据理论耦合的膨胀土胀缩性动态评价
一、论文基本信息
论文题目:
基于偏联系数-证据理论耦合模型的膨胀土胀缩性动态综合评价
作者: 刘秋燕、许小卫(安徽财经大学
管理科学与工程学院) 发表: 《兰州工业学院学报》2026,
33(3): 100–104 | 文章编号: 2097-6909(2026)03-0100-05
基金: 安徽省高校科研计划重点项目(2023AH050267)
膨胀土吸水膨胀、失水收缩,每年造成的经济损失超过 900
亿元。要决定地基怎么处理,先得判定土体的胀缩等级。
论文的答案:用联系数的"同异反"把指标值与分级标准的符合/差异/对立关系量化,用证据理论把
5
个指标相互冲突的信息融合成一个概率分布,用距离函数把动态权重与熵权组合起来,最后用偏联系数把"定级"升级为"给出向邻近等级转化的趋势强度"。
二、模型骨架
模型由两个维度交叉而成,看懂这两个维度就看懂了全文。
维度一:两种权重(静态 + 动态)
静态权重 \(y\)
动态权重 \(w\)
...
DEA模型复现介绍:带有资源约束的模糊DEA线性生产博弈
DEA模型复现介绍:带有资源约束的模糊DEA线性生产博弈
一、论文基本信息
论文题目:
带有资源约束的模糊DEA线性生产博弈模型及分配
作者: 南江霞、吴小勇、李西娜、张茂军
发表: 《控制与决策》2023, 38(11): 3231–3241 | DOI:
10.13195/j.kzyjc.2021.2179
三家云服务供应商各自有
CPU、内存、存储,都能把物理机虚拟成四种虚拟机。联合生产多出来的收益怎么分,才能让所有人都不退出联盟?
论文的答案:用 DEA 让技术系数随数据动态变化,用模糊数
α-截集处理价格与资源的不确定性,用乐观/悲观双角度框出收益区间,最后用
α-核心锁住分配稳定性。
二、模型骨架
模型由两个维度交叉而成,看懂这两个维度就看懂了全文。
维度一:两种合作水平
合作水平 I
合作水平 II
共享内容
技术 + 资源
仅资源
技术集合
联盟全部观测 \(D(S)\)
局中人自身观测 \(D(i)\)
合作难度
高
低(现实中更普遍)
收益
高
低
...
DEA模型复现介绍:非对称纳什-核心讨价还价成本分摊三模型(固定成本 + 可变成本)
DEA模型复现介绍:非对称纳什-核心讨价还价成本分摊三模型
一、论文基本信息
论文题目:
基于非对称纳什合作博弈理论的DEA成本分摊研究(Cost allocation
method using asymmetrical Nash bargaining DEA game)
作者: 王青筠(导师:孟凡永 教授)
单位: 中南大学 管理科学与工程 年份:
2024 年 5 月(硕士学位论文,71 页,2 图 18 表 83 篇参考文献)
同题英文期刊版: Fixed cost allocation using
asymmetrical core-Nash bargaining DEA game, Journal of the
Operational Research Society, 2023/2024
这篇论文做的是成本分摊里一个非常经典、又非常容易被做浅的问题:
一组同质的决策单元(DMU)共同使用一个平台、共享一套资源时,产生的共同成本应该怎么分,才能让所有人都愿意继续合作?
它给出的答案是:把 DEA
的效率评价能力,和合作博弈的分配理论缝在一起 ...
动态综合评价模型复现介绍:具有趋优特征的动态综合评价方法
动态综合评价模型复现介绍:具有趋优特征的动态综合评价方法
一、论文基本信息
论文题目:
具有趋优特征的动态综合评价方法及其应用
英文题目: Dynamic Comprehensive Evaluation Method with
Approximate Optimal Feature and Its Application
作者: 何意雄
学位授予单位: 南昌大学
导师: 张发明 教授
答辩日期: 2017 年 5 月 27 日
类型: 硕士学位论文(技术经济及管理)
这篇文章讨论的是动态综合评价里一个很实在、但容易被绕过去的问题:
当我们要对同一批对象在多个时期的表现做综合评价时,各个时期的权重到底该怎么定?
大部分做法要么"一视同仁",要么按"厚今薄古"(越近的时期越重要)来赋权。
这篇论文说:还不够。还要看系统在哪个时期整体发展得更好。
也正是这一点,构成了全文的核心创新。
二、这篇文章解决了什么问题?
传统 TOWA 算子的盲区
郭亚军教授提出的 TOWA
算子(时序加权平均算子),是动态综合评价里运用最广的信息集结工具。它用" ...
DEA模型复现介绍:负数据下的逆DEA-R模型(Inverse ratio-based DEA for negative data)
DEA模型复现介绍:负数据下的逆DEA-R模型
一、论文(章节)基本信息
来源: Advanced Topics in Inverse Data
Envelopment Analysis: Approaches for Handling Ratio
Data(SOLTANIFAR 等,2025)
第 8 章: Inverse ratio-based DEA models for input
and output estimation in the presence of negative data(书页
221–247)
核心模型: 模型 (4.25)(效率评价)+ 模型 (8.1)(逆
DEA-R 产出估计)
实现: Julia + JuMP + HiGHS
这篇文章讨论的是 DEA 里一个既常见、又很难处理的经营决策问题:
如果一家机构下一期计划把投入增加
12.5%,同时要求「效率不降」,那么它的产出应该提高到什么水平?
对很多管理者来说,这正是做预算、定目标、配资源时最想问的前瞻性问题——不是事后评价谁好谁差,而是事前告诉我该把产出定到多少。 ...
DEA模型复现介绍:Shannon 熵提高DEA判别力综合效率评价模型
DEA模型复现介绍:Shannon熵提高DEA判别力的综合效率评价模型
一、论文基本信息
论文题目: Increasing the Discriminatory Power of
DEA Using Shannon's Entropy
期刊: Entropy
年份: 2014
卷期页码: 16, 1571–1585
作者: Qiwei Xie, Qianzhi Dai, Yongjun Li, An Jiang
这篇文章讨论的是 DEA 里一个很典型、又有点“两难”的问题:
当变量数量相对于决策单元(DMU)数量过多时,传统 DEA
的判别力会急剧下降,很多 DMU
都被判成“有效”,无法区分、无法完整排序。如何在不丢失变量信息的前提下,把判别力提上来?
这正是本文要解决的问题,答案就是——用 Shannon
熵做“加权聚合”。
二、这篇文章解决了什么问题?
传统 DEA(以 CCR 为例)允许每个 DMU
在约束下自由选择对自己最有利的权重来最大化自身效率。这样带来的副作用是:
变量越多,权重空间的维数越高,越容易有更多 DMU 被判 ...
指标太多,DEA还怎么用?一种能自动‘挑变量’的进攻型方法
指标太多,DEA还怎么用?一种能自动“挑变量”的进攻型方法
做效率评价的人,几乎都遇到过这个尴尬。
明明想用数据包络分析(DEA)给一批对象打分,可指标一多,问题就来了:大家都变成有效了,分数全在
1 附近,谁也分不出高下。
这不是你不会用,而是 DEA
天生的毛病。它需要指标少、样本多,才有判别力。可实际情况往往反着来——评价对象就那么几十个,候选指标倒有上百个。
过去遇到这种情况,要么靠专家经验拍脑袋删指标,要么用主成分分析、相关系数这类统计办法做降维。但这些做法要么主观,要么跟
DEA 的初衷脱节。
今天想聊的,是把“选哪些指标”这件事直接做进 DEA 里的一种办法。它来自
2026 年发在 Expert Systems With Applications 上的一篇论文,叫
ACDEA,进攻型集中式 DEA 变量选择。
一、它的立场:进攻,而不是讨好
先看它跟传统做法最大的不同。
DEA
里常见的变量选择多是“仁慈型”——让每个评价对象挑对自己最有利的指标,尽量把大家都显得有效率。可大家都高效了,排名还有什么意义?判别力反而被牺牲。
ACDEA
反 ...