fsQCA Studio:零基础也能做出规范的模糊集定性比较分析
fsQCA Studio:零基础也能做出规范的模糊集定性比较分析
副标题候选:一个 R Shiny 工作台,把校准、必要性、真值表、组态、稳健性、可复现报告全串起来(附真实运行结果)
一句话:给第一次做 fsQCA(模糊集定性比较分析)的人用的软件——不写代码、不查手册,15 分钟从一份 CSV 走到能直接放进论文的组态表;顺便把现有软件缺的 RoN、PRI 诊断、稳健性检验和可复现脚本全都补上。
先看一次真实的运行结果
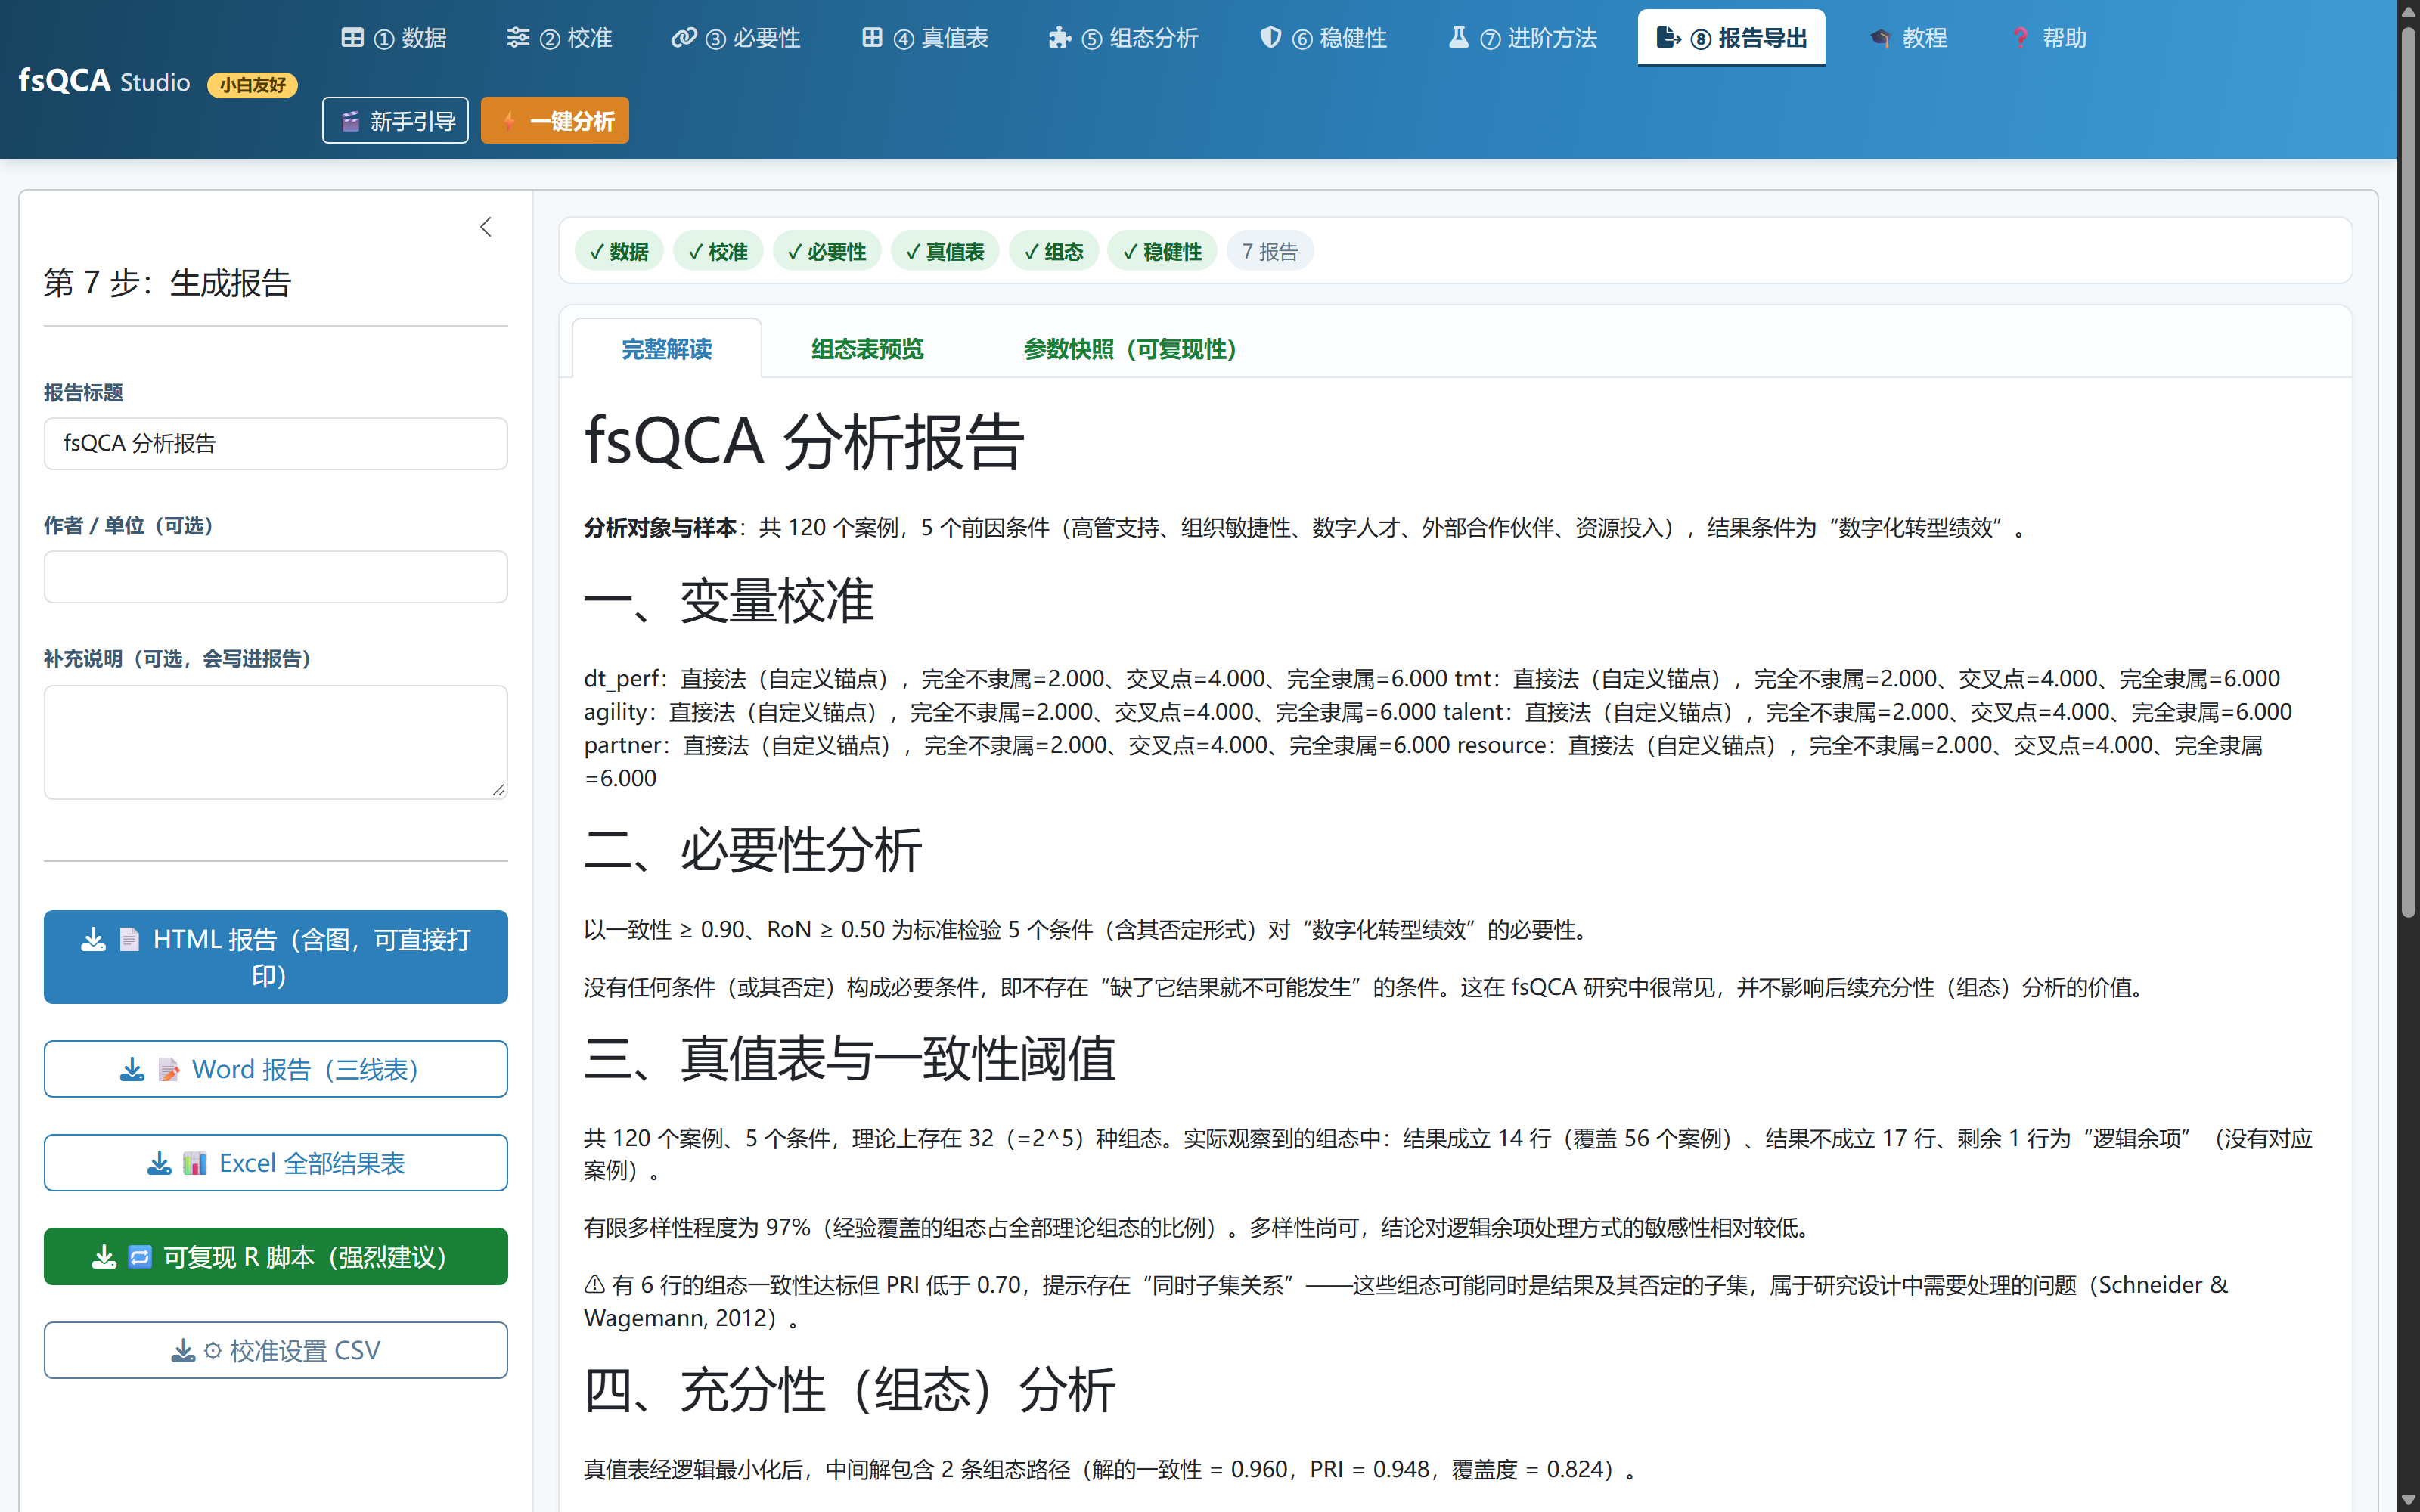
数据:120 家制造企业的数字化转型问卷(7 点量表,5 个前因条件)。 模型:校准(理论锚点 2 / 4 / 6)→ 真值表(一致性 0.80、PRI 0.70、频数 1)→ 中间解。
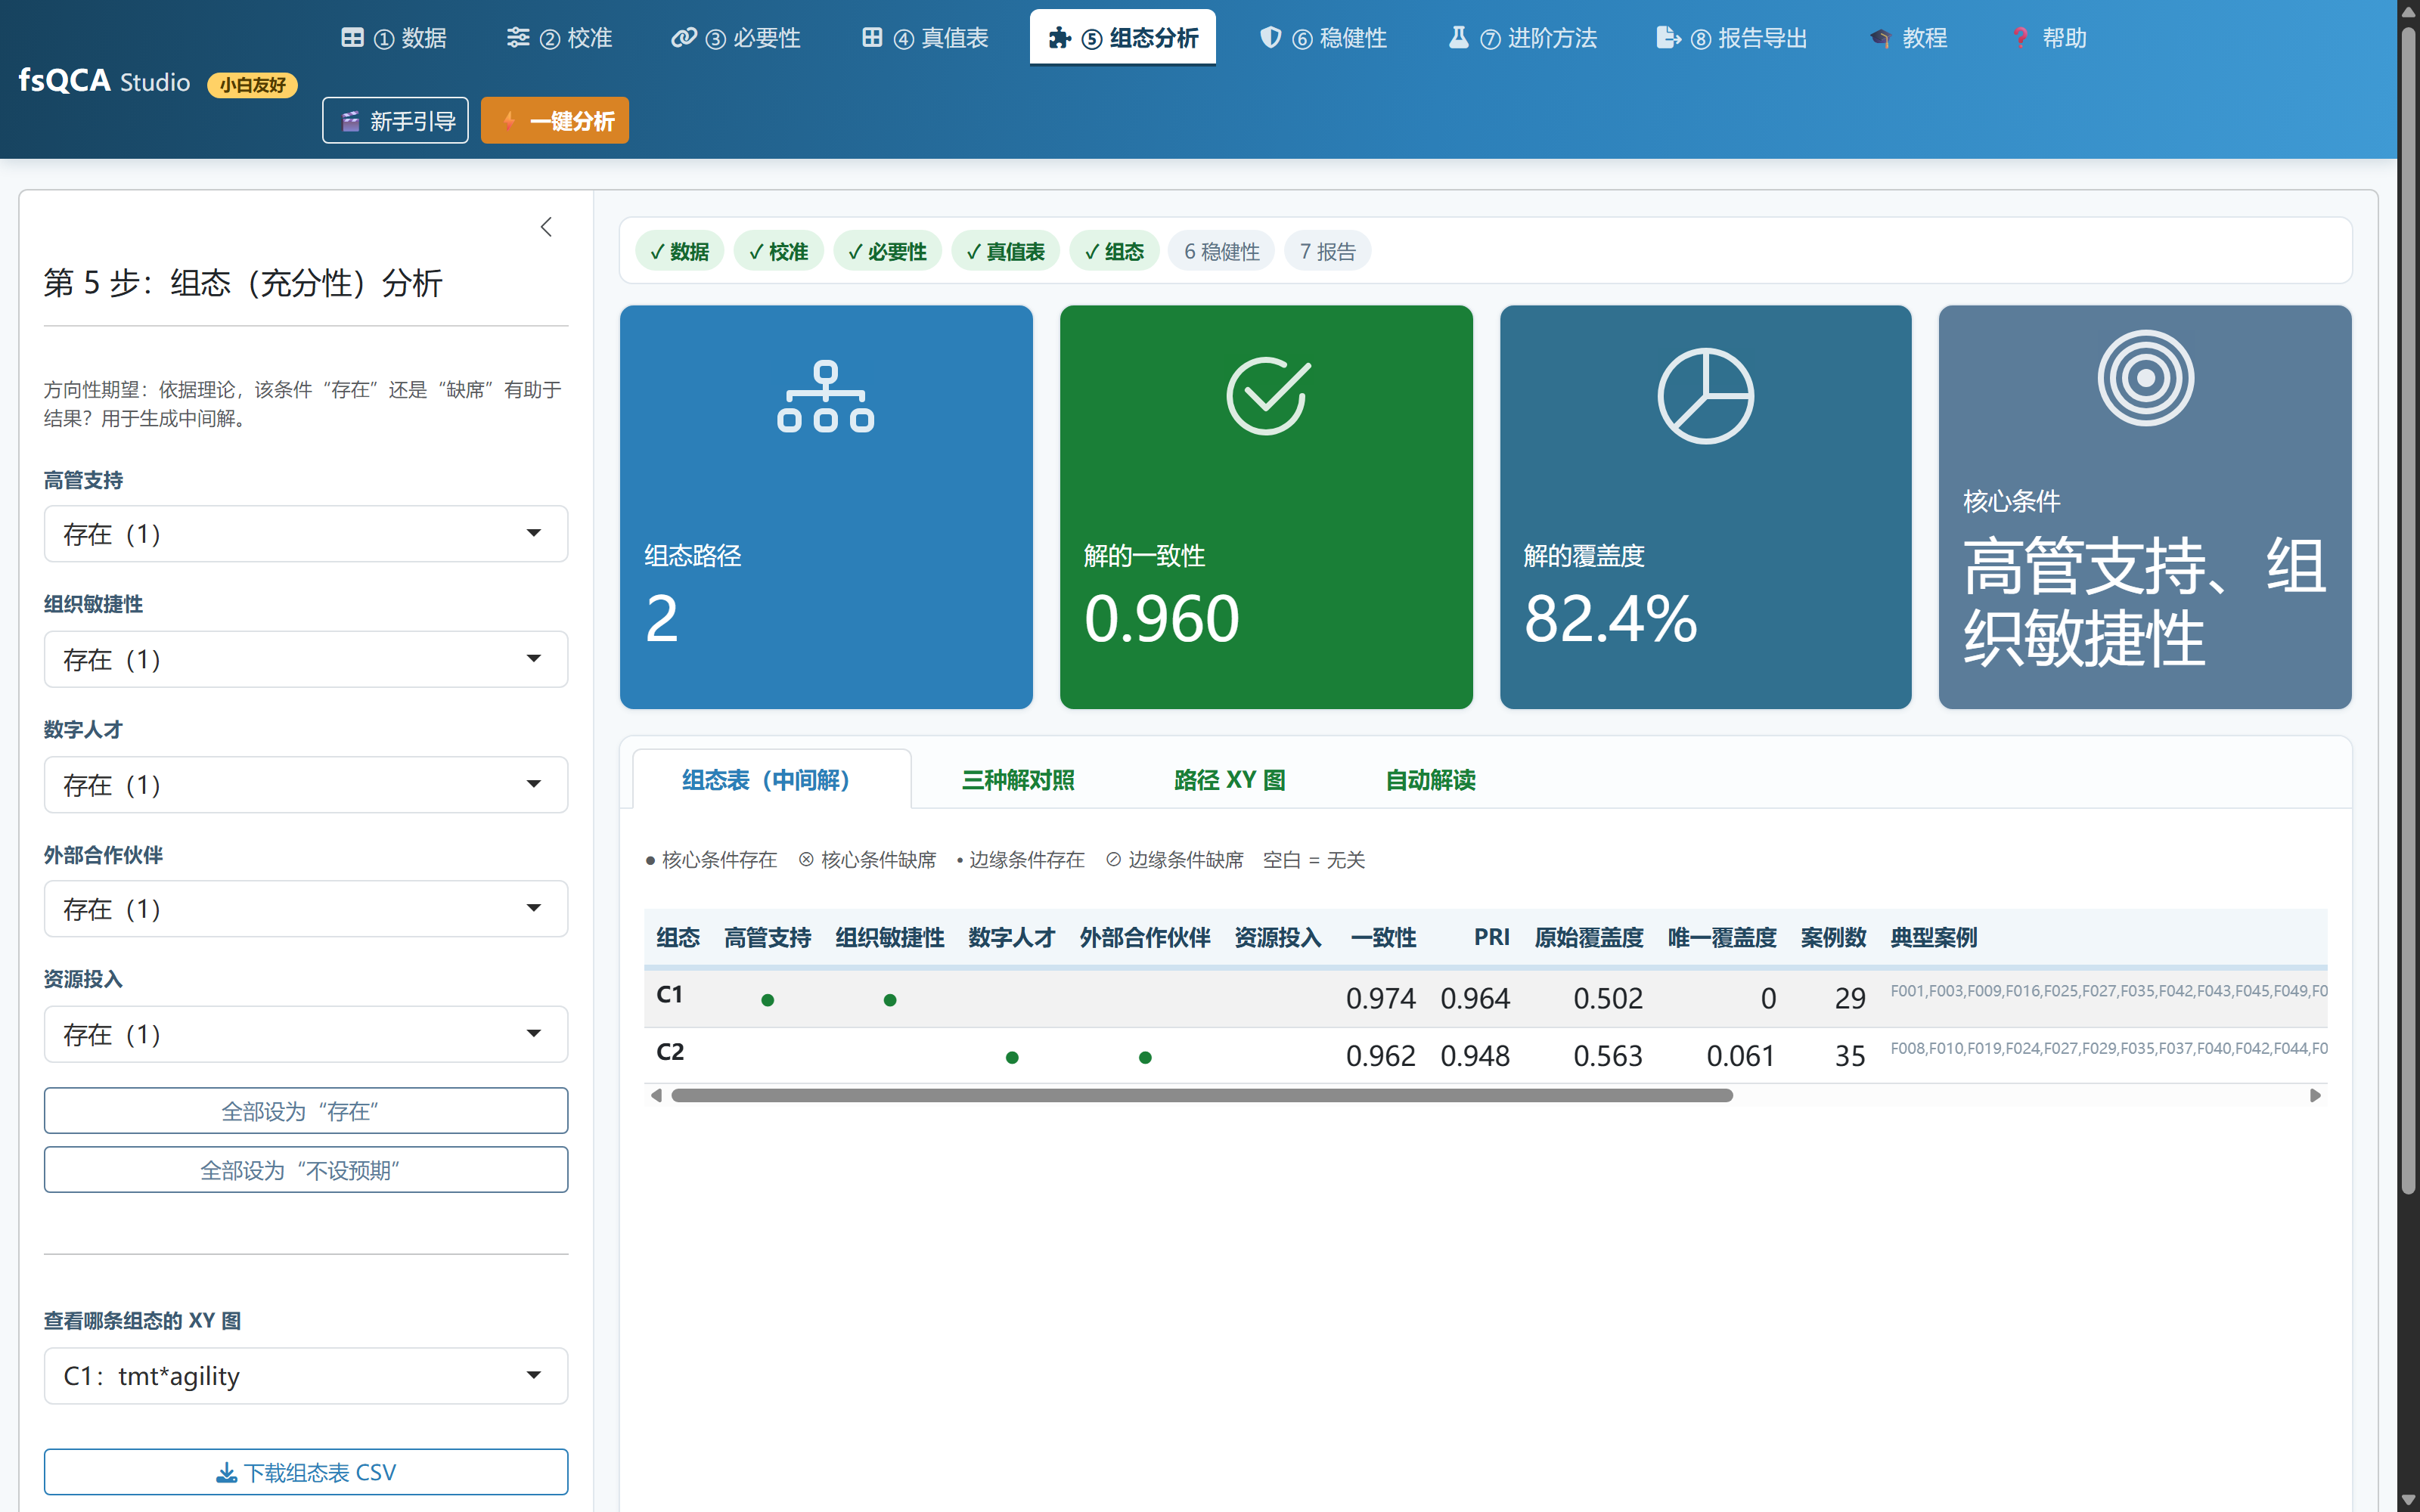
跑出来的组态表是这样(软件原始截图,不是我画的):
| 组态 | 高管支持 | 组织敏捷性 | 数字人才 | 外部伙伴 | 资源投入 | 一致性 | PRI | 原始覆盖度 | 唯一覆盖度 | 案例数 |
|---|---|---|---|---|---|---|---|---|---|---|
| C1 | ● | ● | 0.974 | 0.964 | 0.502 | 0.000 | 29 | |||
| C2 | ● | ● | 0.962 | 0.948 | 0.563 | 0.061 | 35 |
- 解的一致性 = 0.960,解的覆盖度 = 82.4%
- 核心条件:高管支持、组织敏捷性
- 一句话结论:“内部驱动型”(高管支持 × 组织敏捷性)与“外部借力型”(数字人才 × 外部伙伴)是通往高转型绩效的两条等效路径,合计解释 82.4% 的高绩效案例。
这就是 fsQCA 想回答的问题:不是“谁的影响更大”,而是“什么条件组合下才会成功”。
你是不是也这样过
- 校准锚点凭感觉定,写完才发现审稿人第一句就问“为什么取这个交叉点”;
- 照着教程跑完,只报了简约解,被批“结论过于大胆”;
- 中间解和简约解长得一模一样——因为方向性期望全设成了“不设预期”;
- 表里一致性 0.95 很漂亮,PRI 却只有 0.5,其实存在同时子集关系;
- 换了台电脑重新跑,结果对不上,自己也说不清当时点了什么;
- 结果出来了一堆英文表,不知道怎么把它写成“人话”。
fsQCA Studio 就是针对这些做的。
它长这样:七个步骤,一条线走完
界面顶部是一条进度条,走完就得到论文要的东西:
① 数据 → ② 校准 → ③ 必要性 → ④ 真值表 → ⑤ 组态分析 → ⑥ 稳健性 → ⑦ 报告导出
每一步左边是参数(每个参数旁边有 ?
即时解释),右边是结果和“这一步在干什么”的提示。
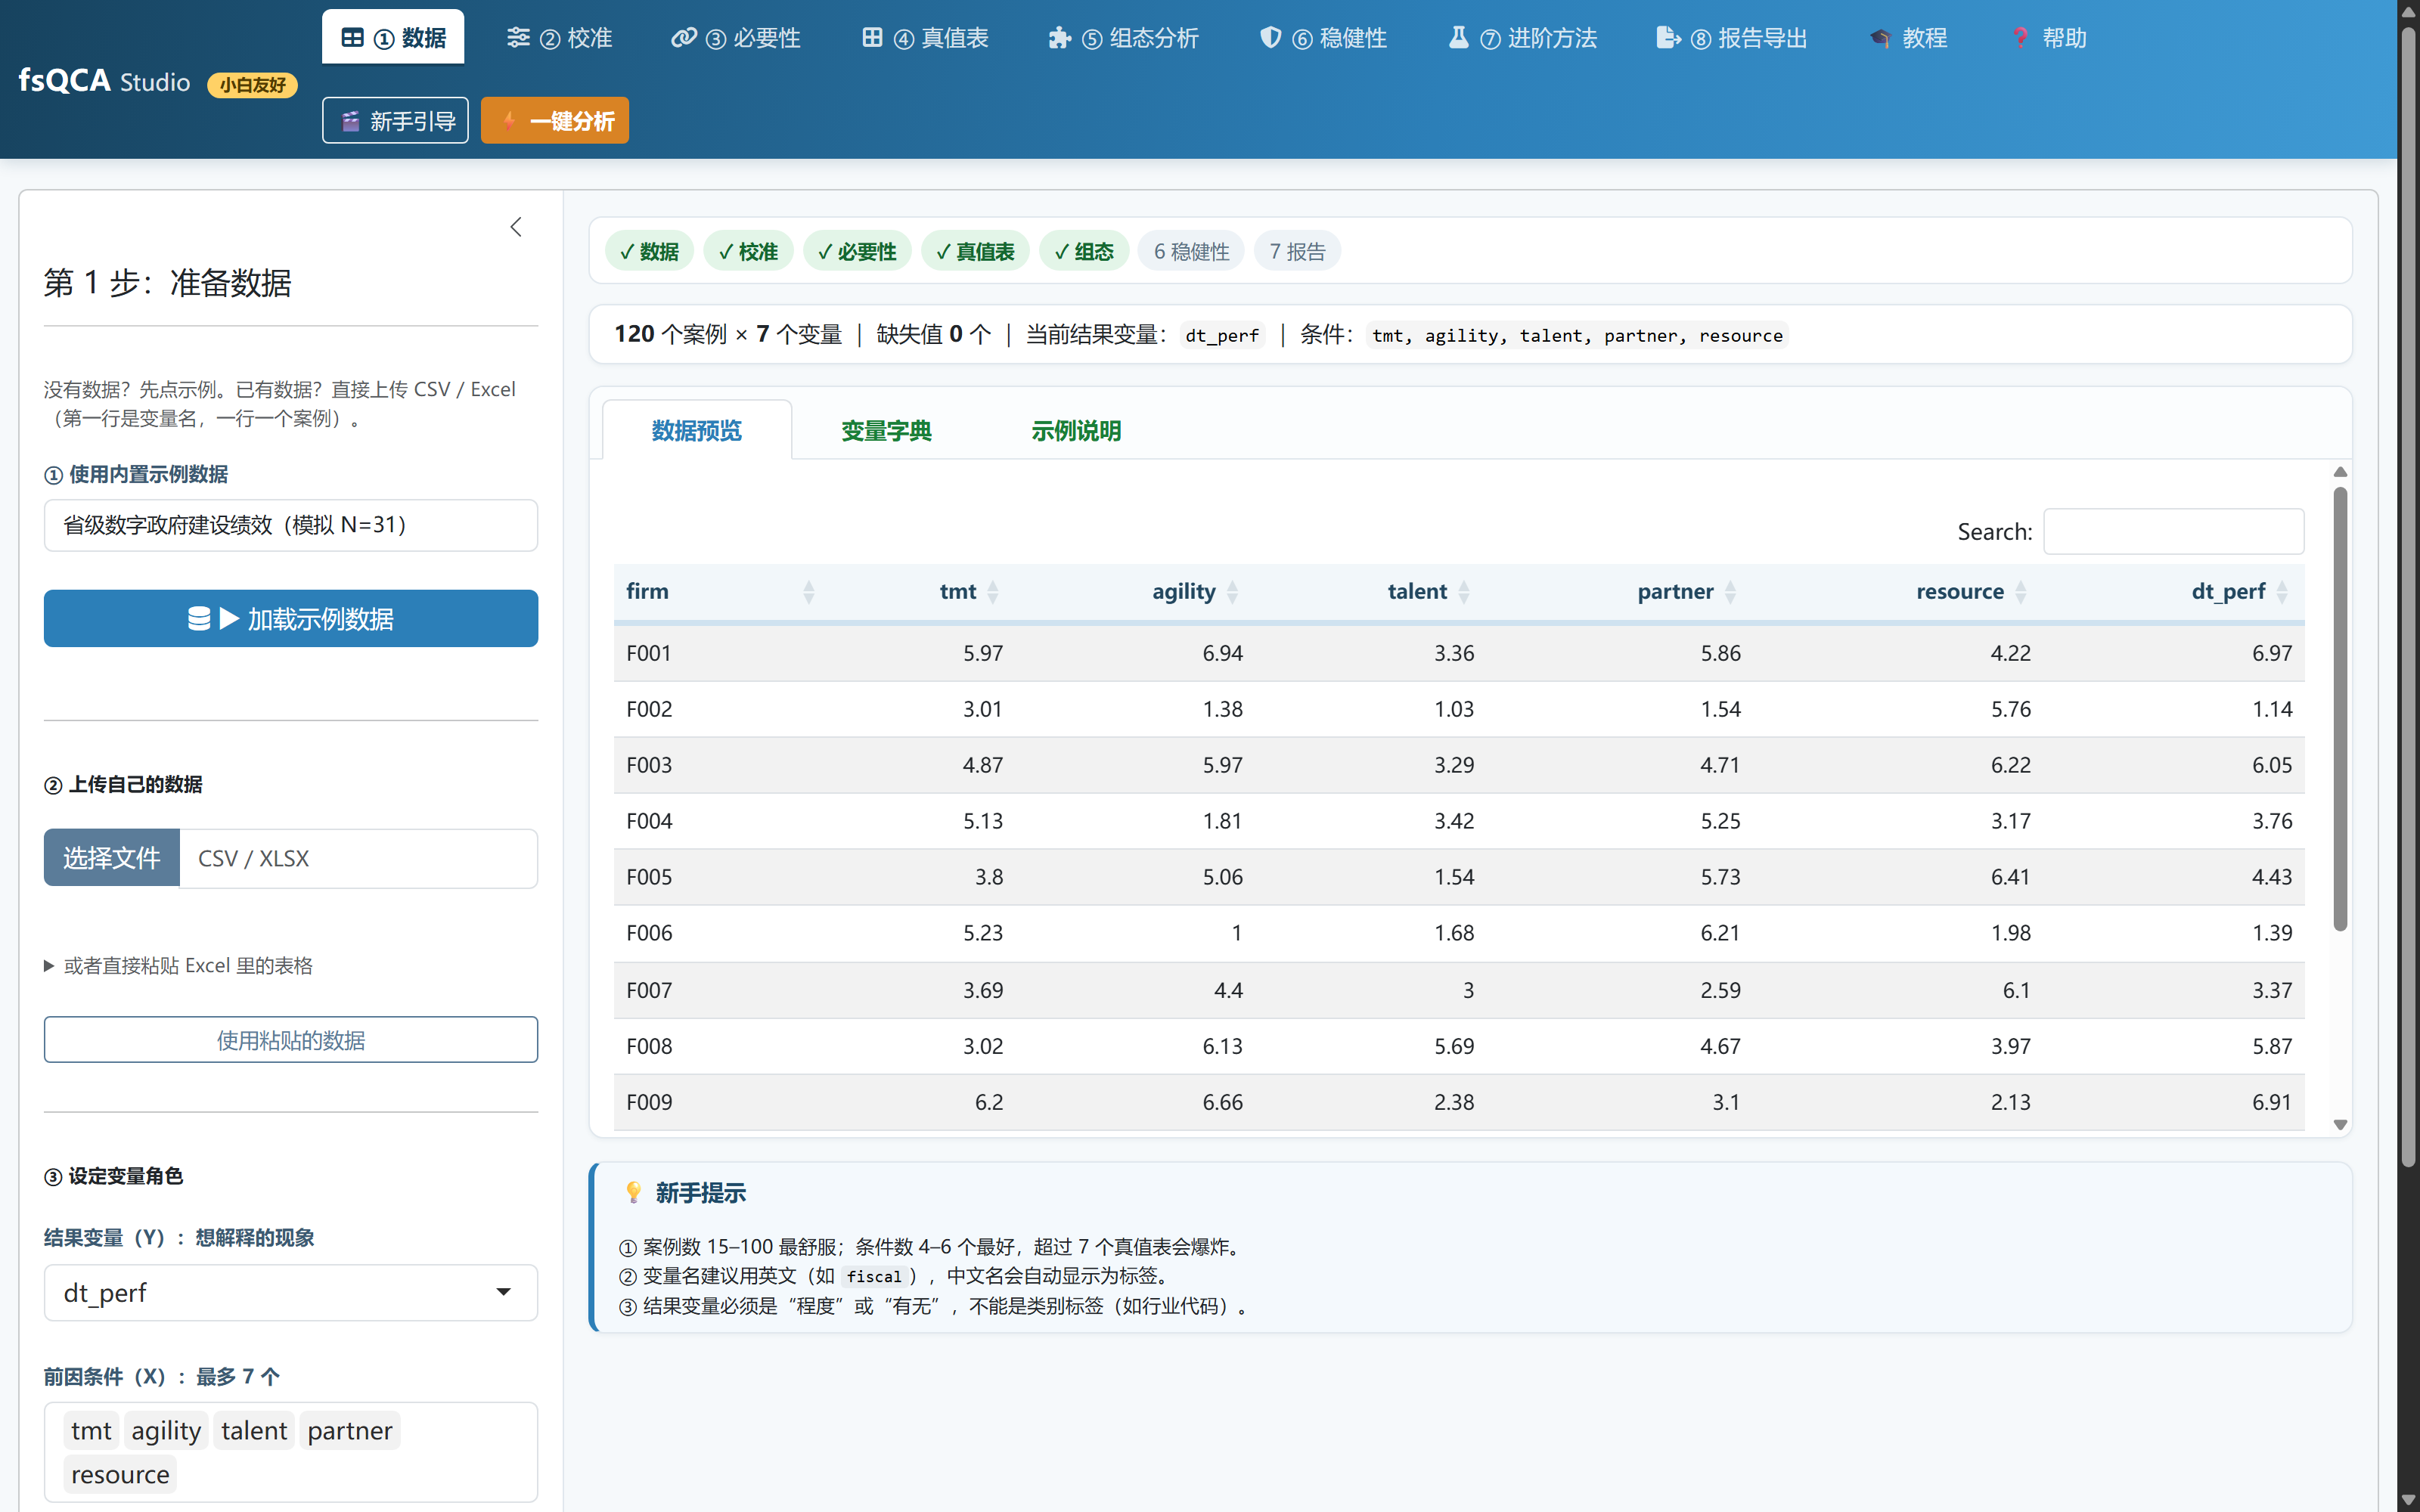
内置 4 套示例数据(入门够用):制造企业数字化转型(N=120)、省级数字政府(N=31)、Lipset 民主稳定性经典案例(N=18)、城市“放管服”改革清晰集(N=32)。也可以直接上传 CSV / Excel,或从 Excel 粘贴。
与其他软件相比,补的是这几个洞
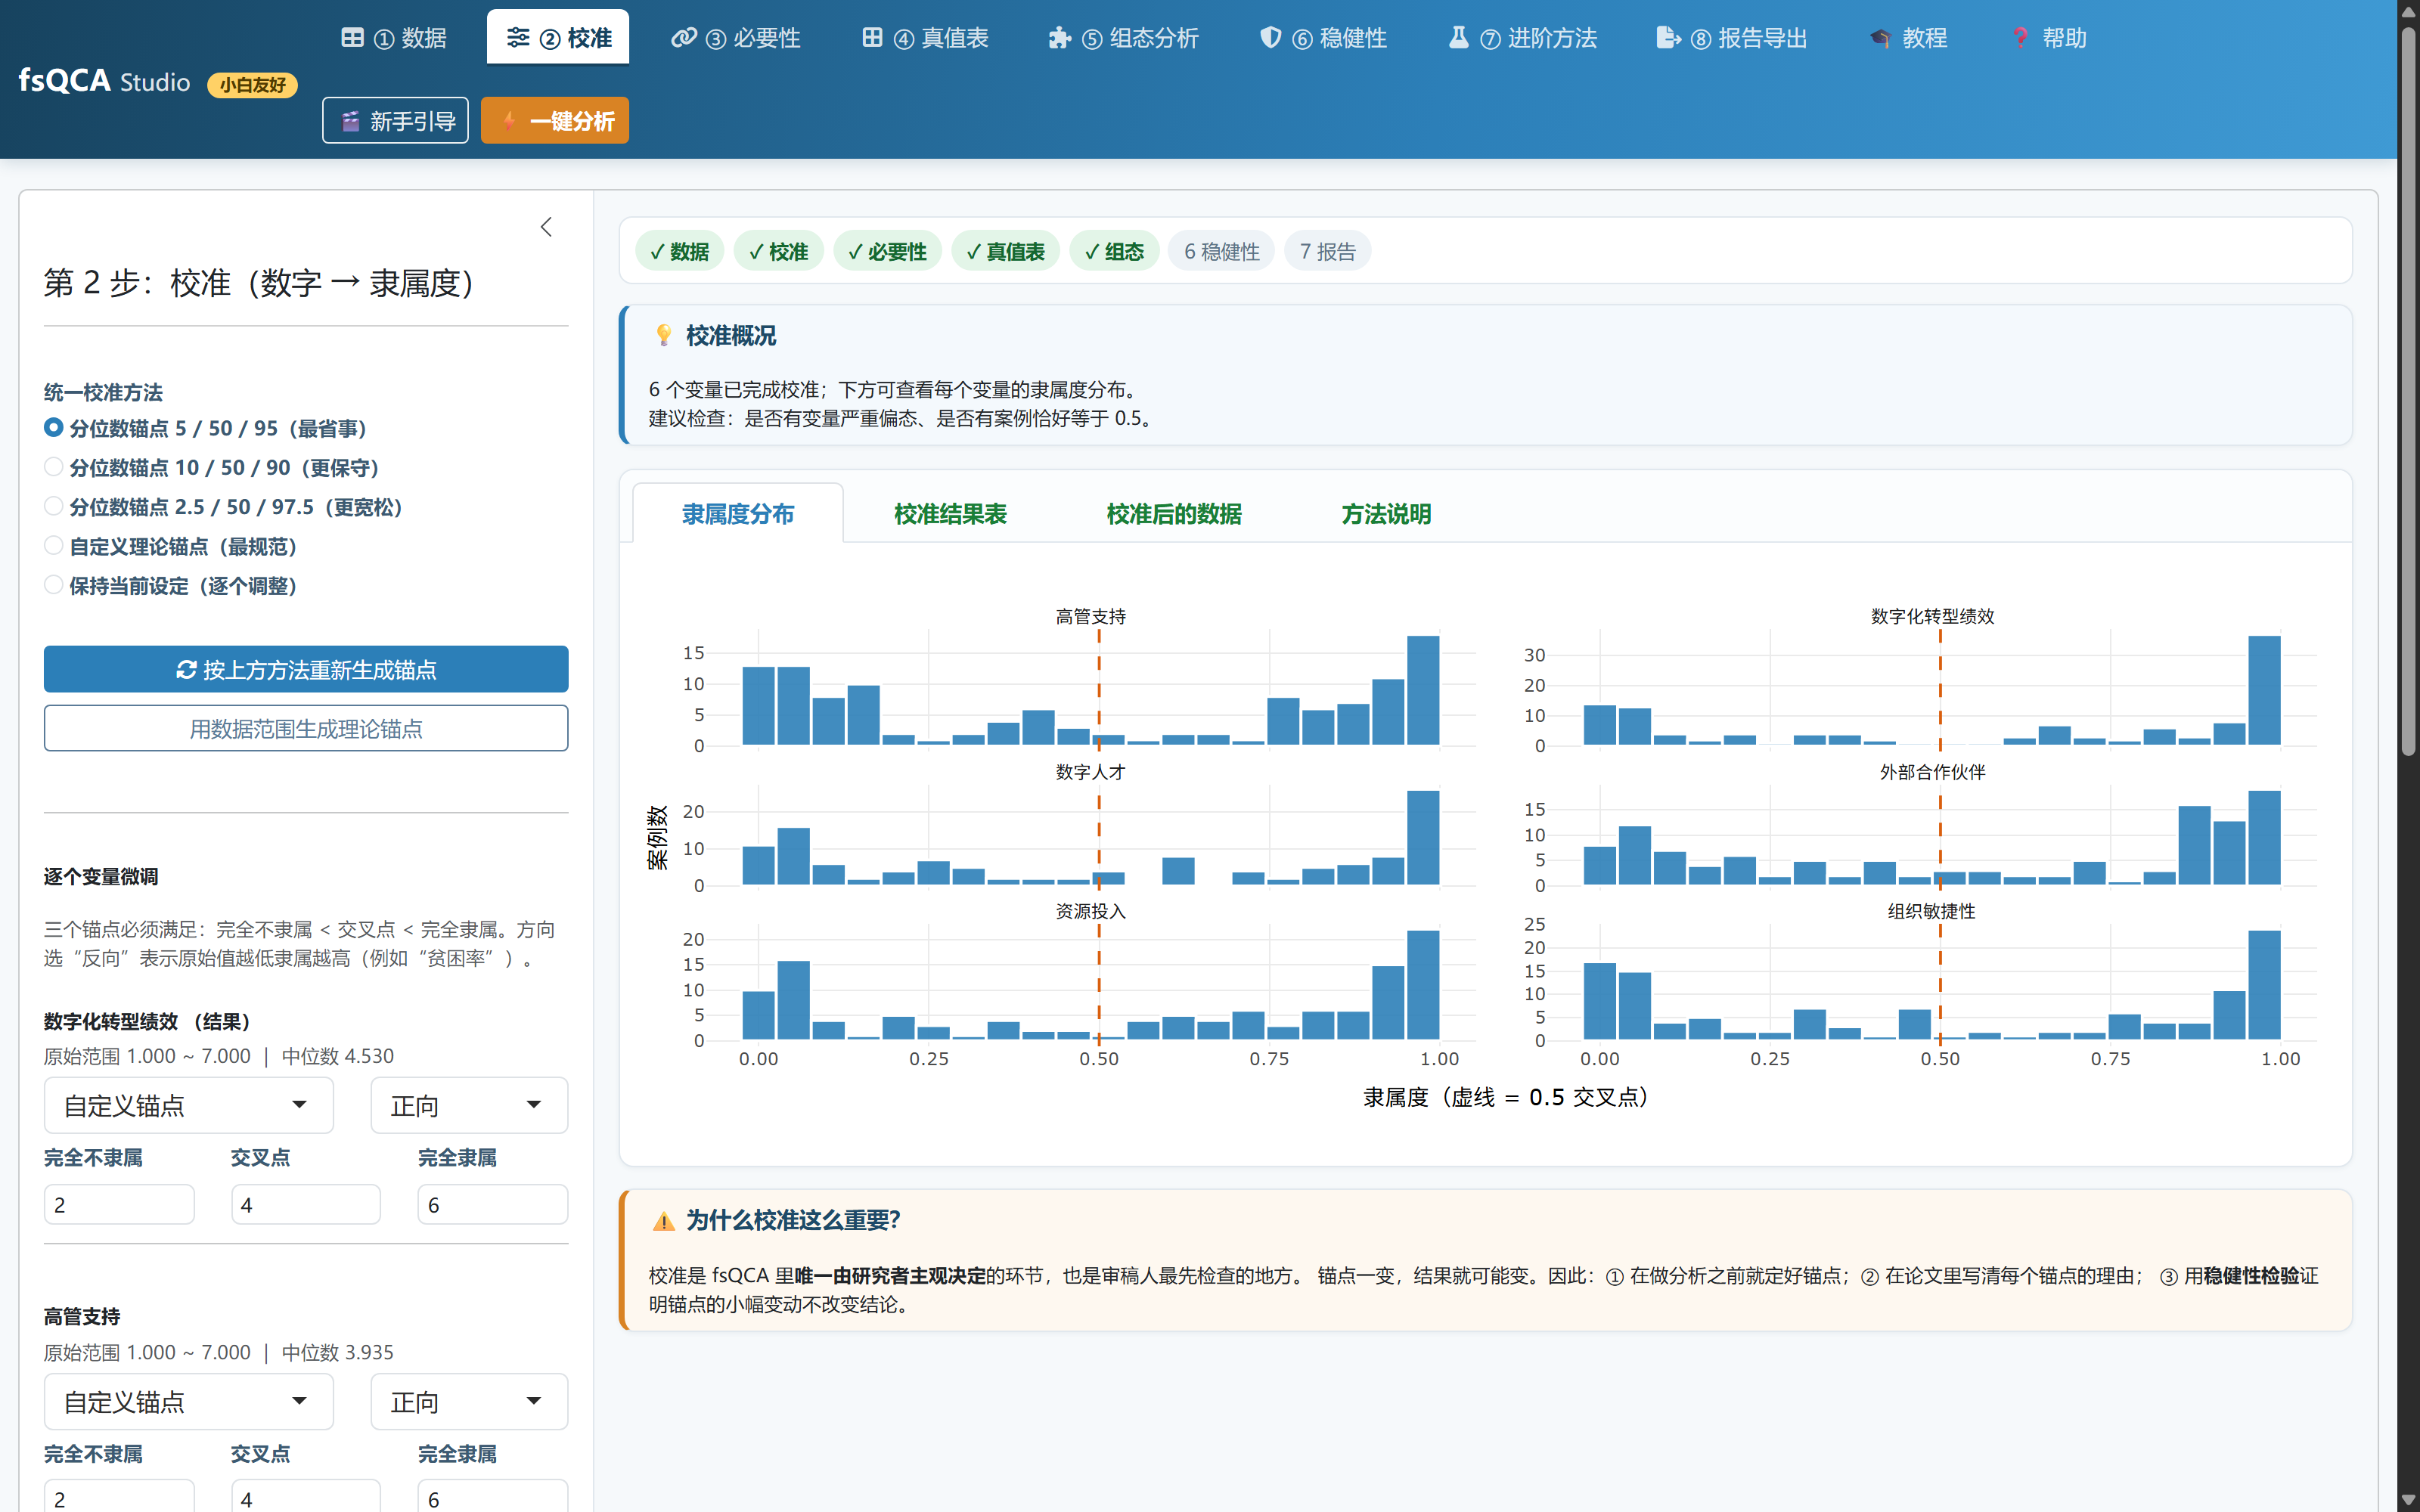
① 校准:三个锚点,实时告诉你哪里不对
直接法(分位数 / 自定义理论锚点)、二分、已是隶属度,四种模式一键切换,每个变量可单独设方法与方向(反向变量如“贫困率”选“反向”)。
软件会自动检查三件事,并且当场告诉你:
- 有案例恰好落在 0.5(“亦此亦彼”)→ 自动把交叉点微调到两个观测值之间;
- 某个变量校准后严重偏态(>90% 在同一侧)→ 提示该条件解释力弱;
- 锚点全落在数据范围之外 → 提示“最大值会被判为完全隶属”。
② 必要性:多数软件没有的 RoN
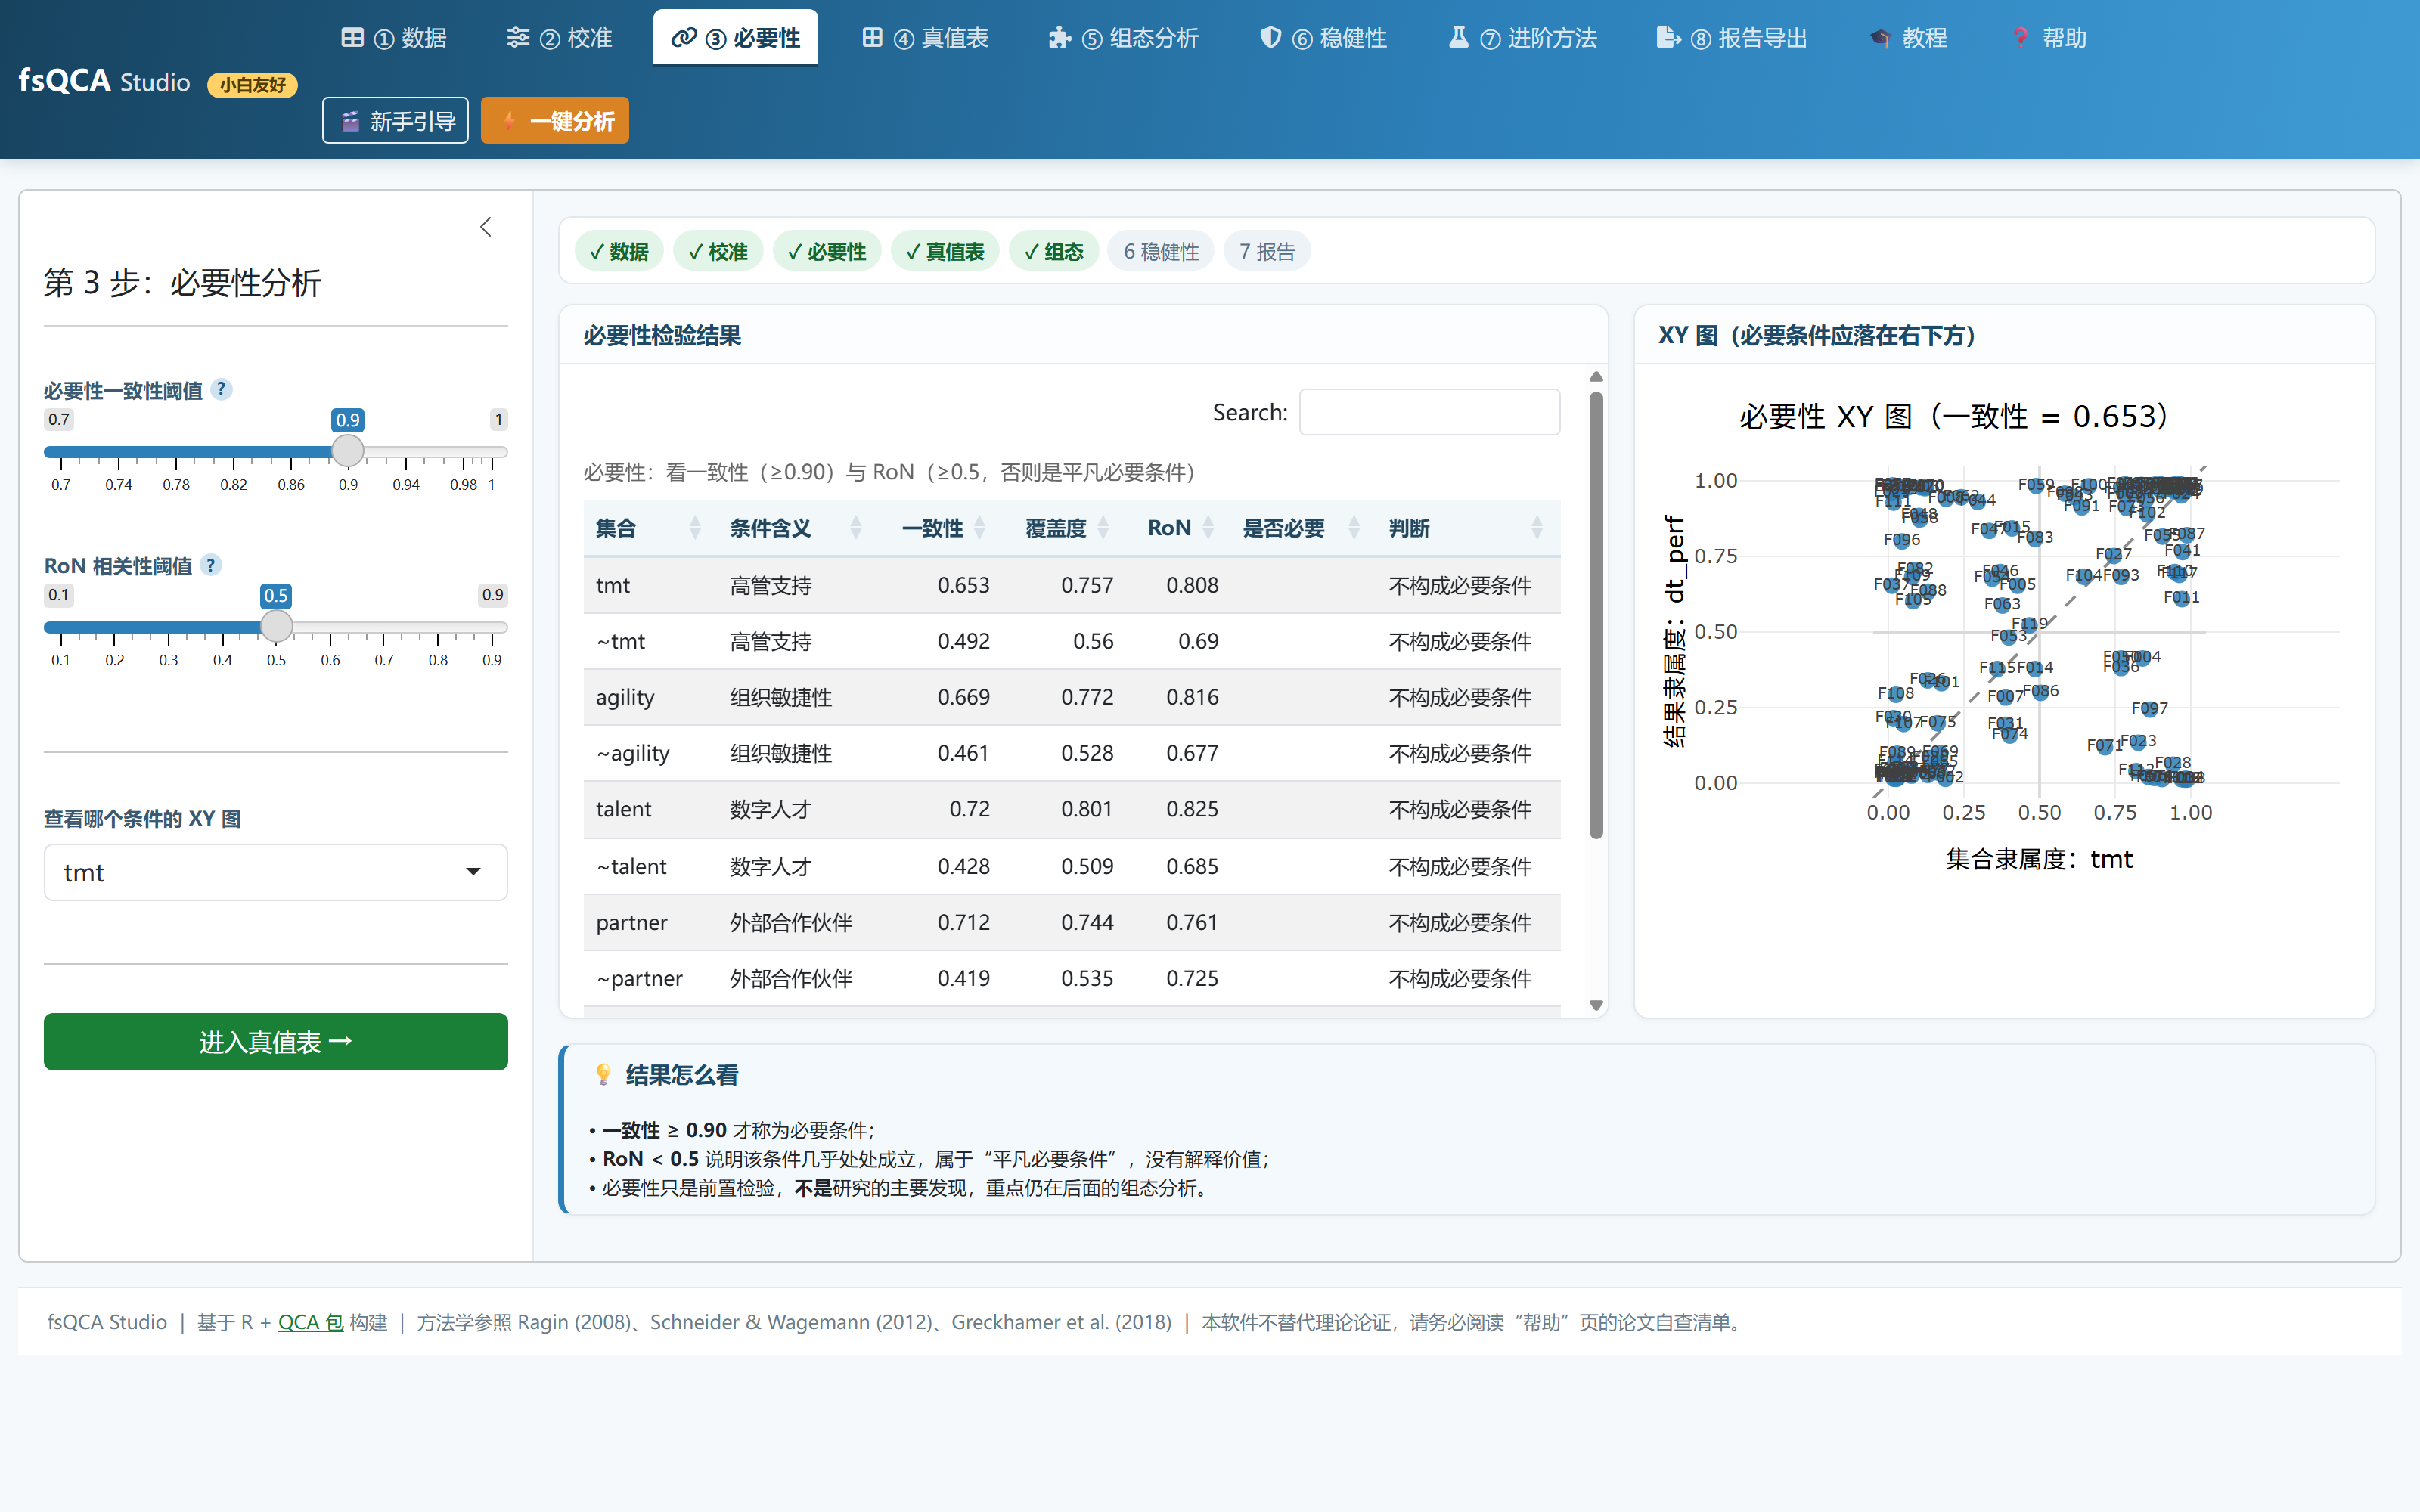
必要性不止看一致性(≥0.90)和覆盖度,还给了 RoN(Relevance of Necessity):
RoN < 0.5 的条件是“平凡必要条件”——它几乎在所有案例里都成立(比如“存在组织”),一致性很高,但毫无解释价值。很多论文把这种条件当成核心发现,是审稿意见的高频靶子。
③ 真值表:自动标出 PRI 风险行
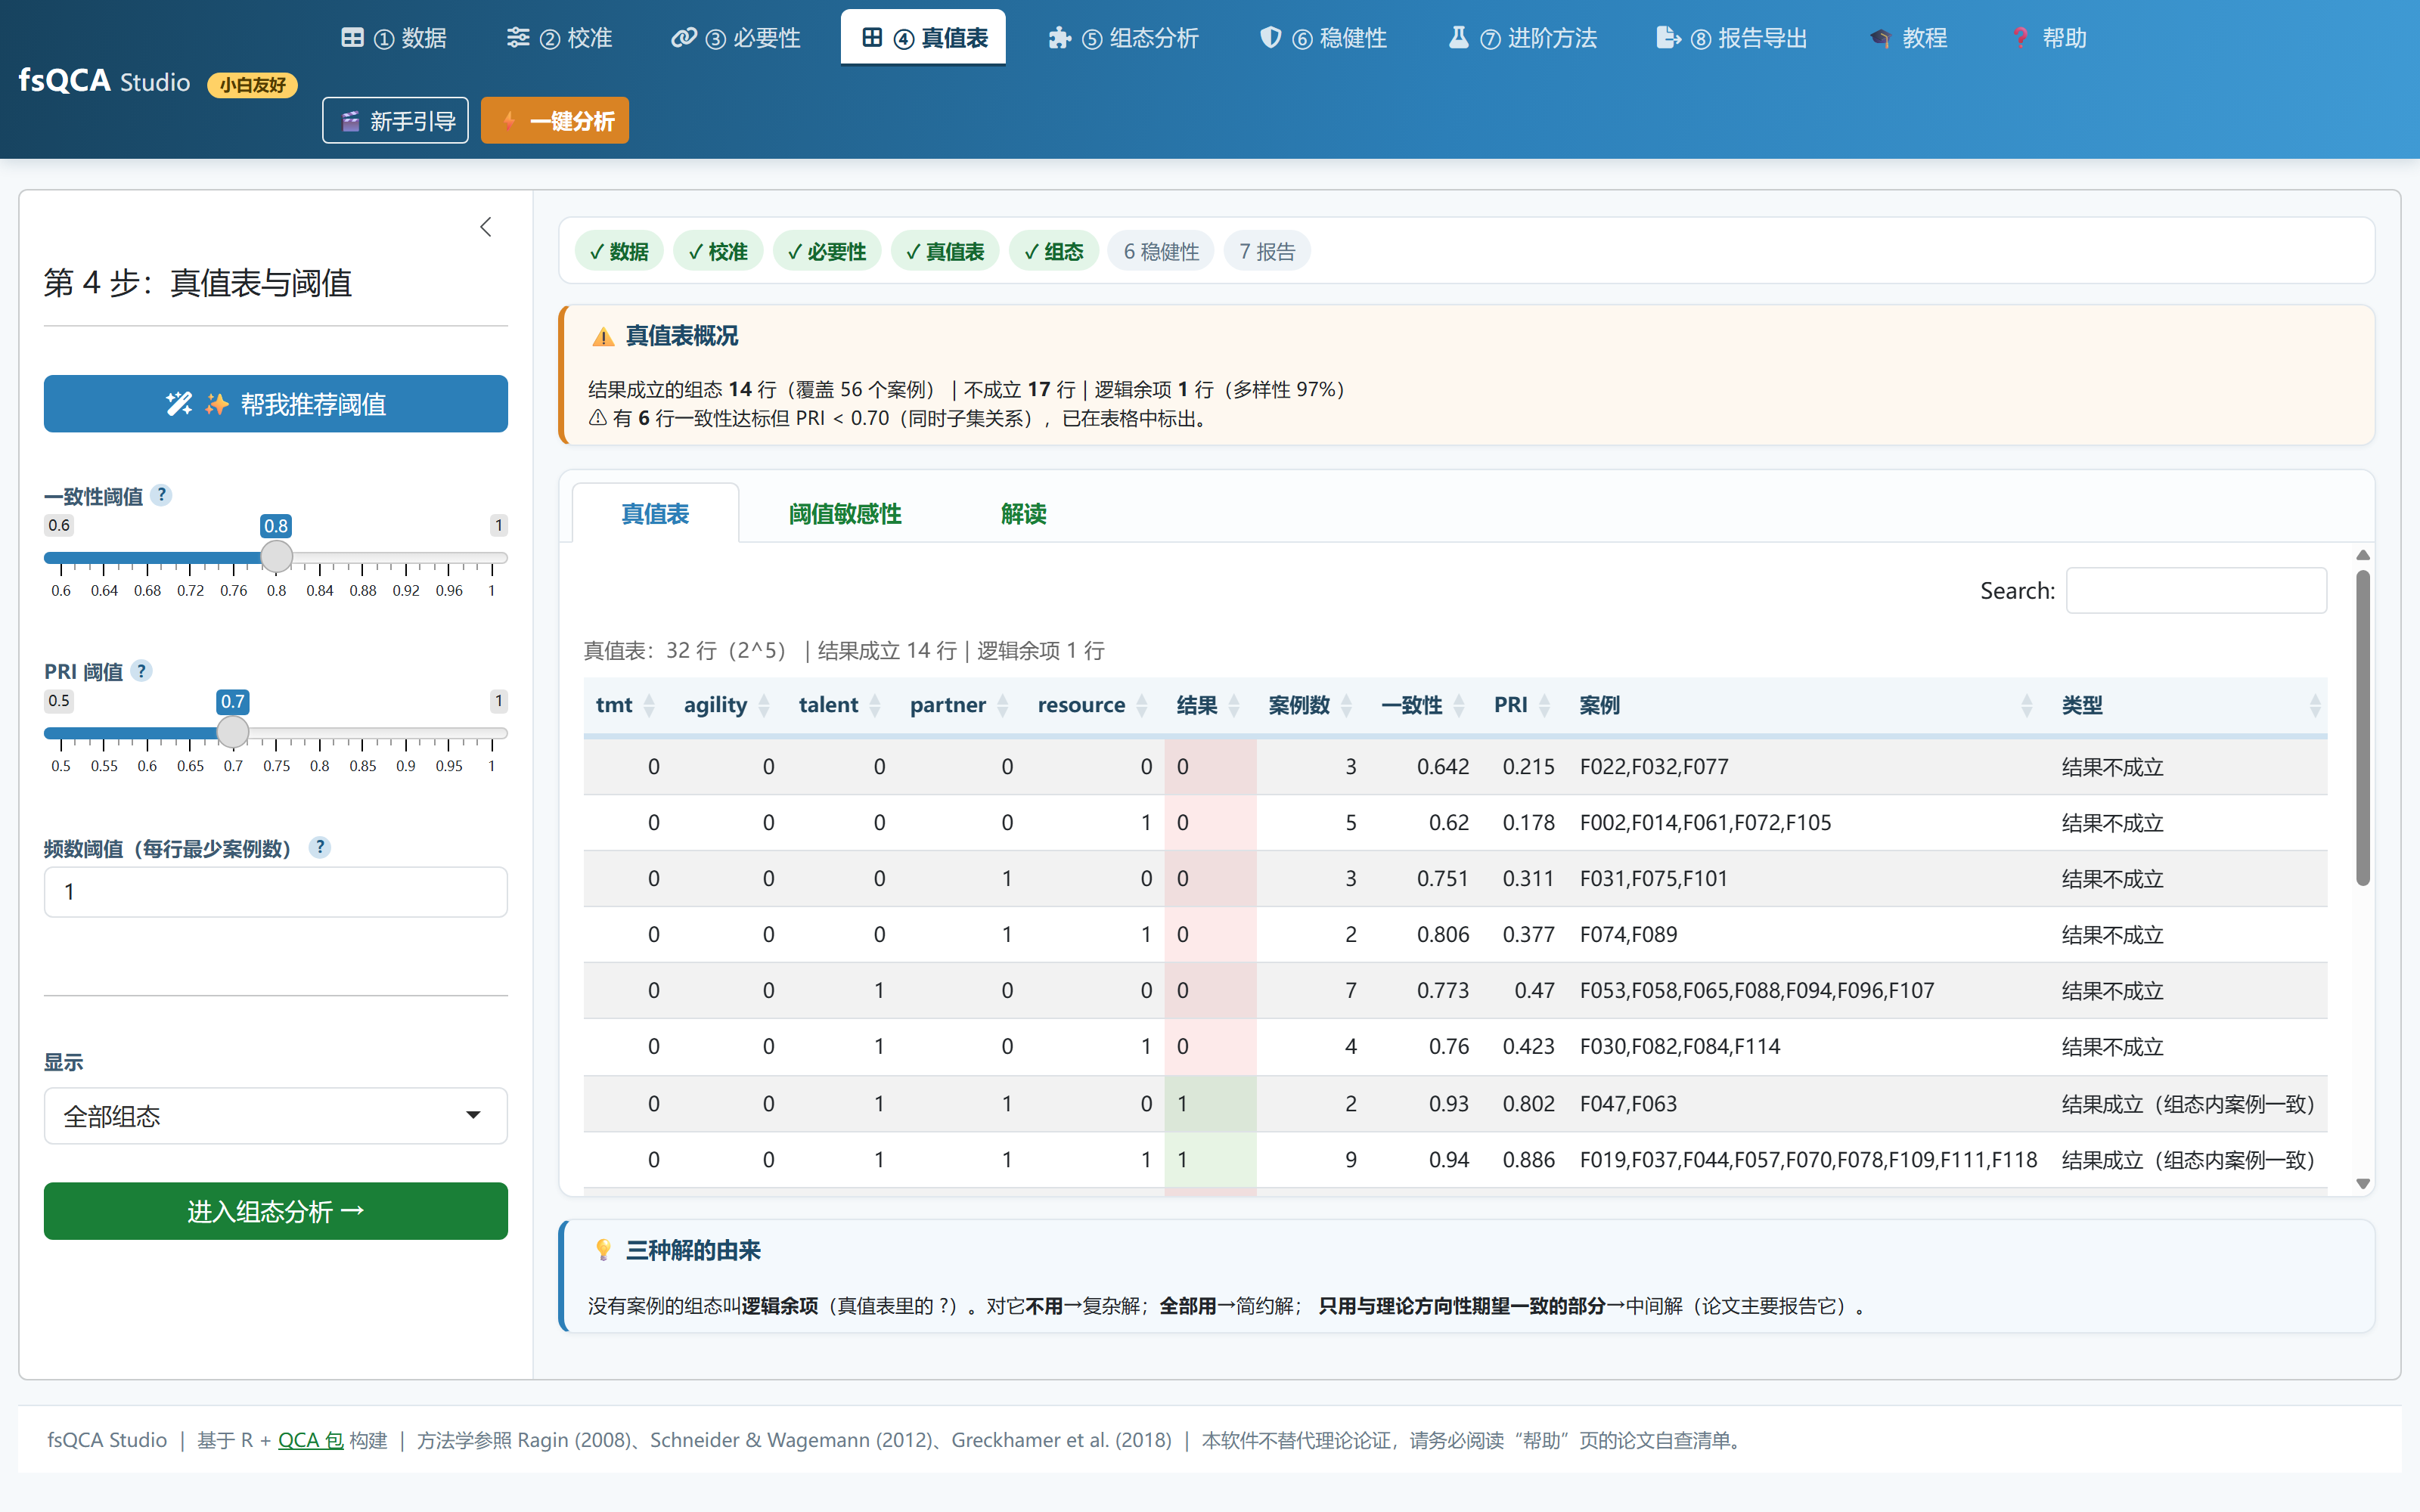
- 自动算逻辑余项占比(有限多样性):余项超过 75% 会明确警告“结论对余项处理高度敏感”;
- 自动标出一致性达标但 PRI < 0.70 的行,并说明这就是“同时子集关系”(某个组态同时是 Y 与 ~Y 的子集);
- 阈值拿不准?点 “✨ 帮我推荐阈值”,它会在一致性分数的断层处给出建议(同时给频数阈值建议)。
④ 组态表:● ⊗ • ⊘ 直接可贴进 Word
中间解自动区分核心条件(● ⊗,简约解与中间解都有)与边缘条件(• ⊘,只在中间解出现),画成论文里那种圆点表,附一致性、PRI、原始覆盖度、唯一覆盖度、案例数与典型案例。
三种解(复杂 / 简约 / 中间)并列展示,各自的一致性、PRI、覆盖度一目了然;底部还有一键复制为制表符,粘进 Word 就是一张表。
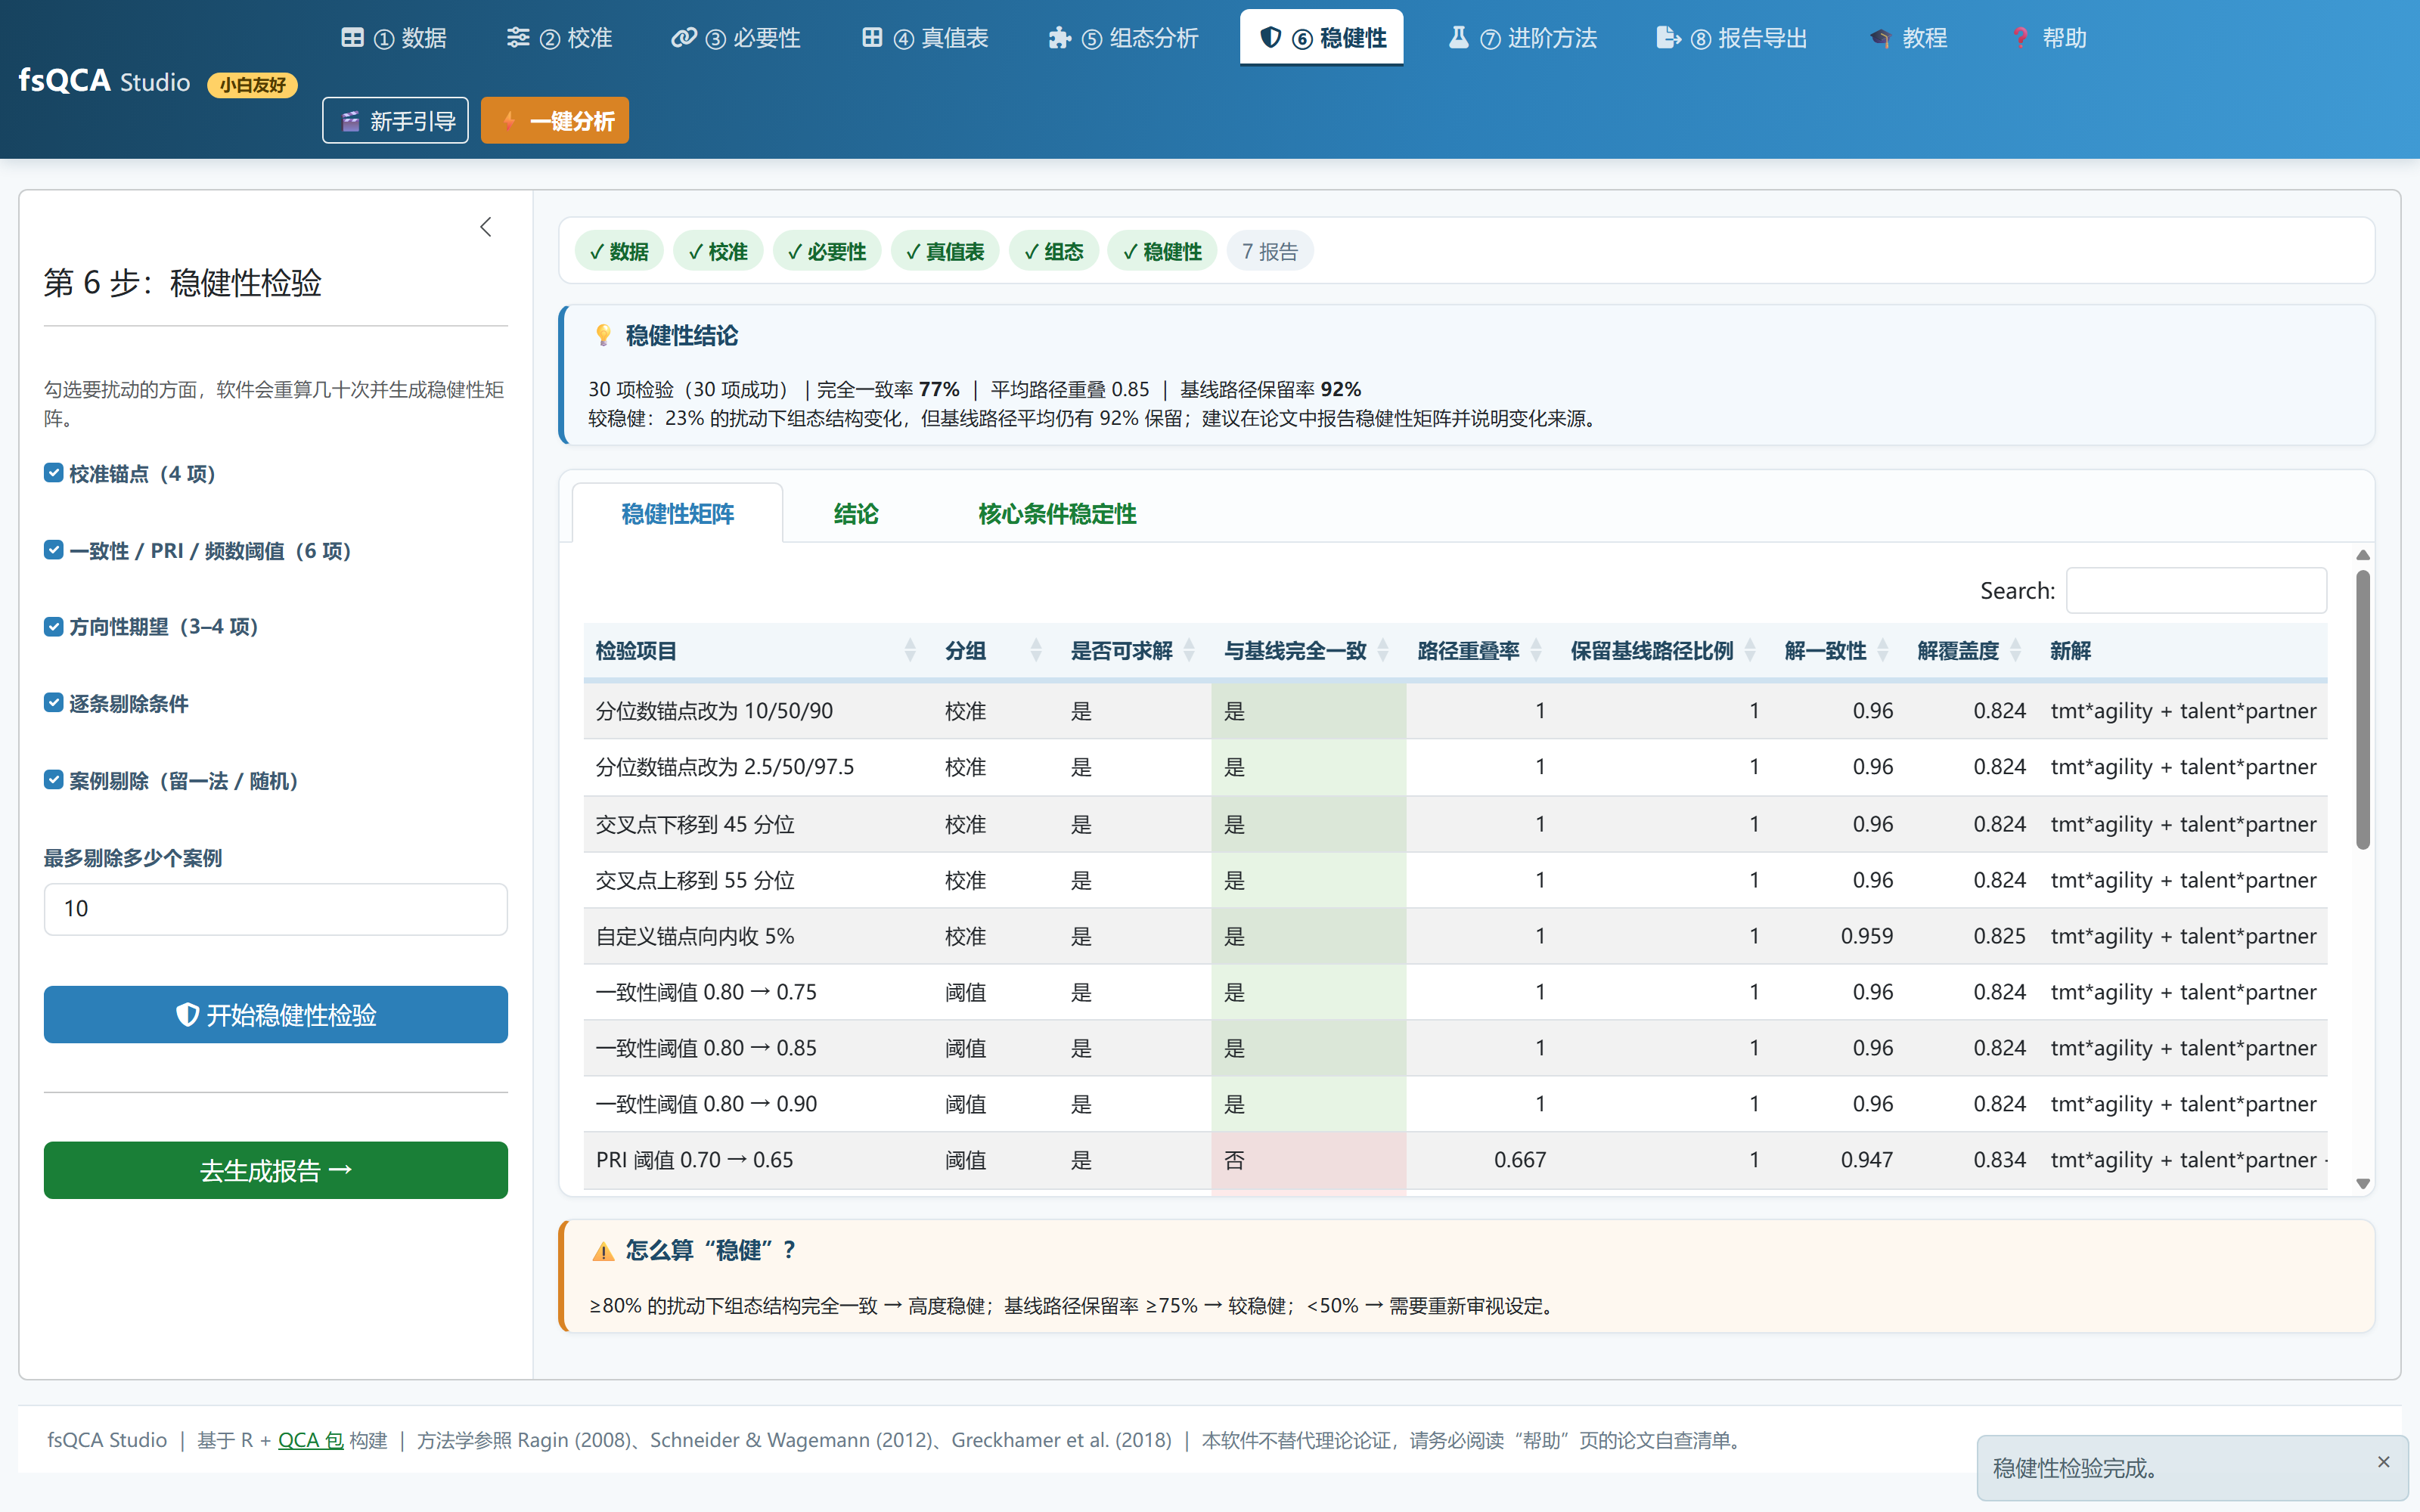
⑤ 稳健性:五类扰动,30 项检验一次跑完
勾选要扰动的方面,点一下:
- 校准锚点(10/50/90、2.5/50/97.5、交叉点 ±5%)
- 一致性 / PRI / 频数阈值(±0.05、±0.10,频数 +1)
- 方向性期望(全部“存在”、全部“不设预期”、全部取反)
- 逐条剔除条件
- 留一法剔除案例
跑完直接给中文结论。这次真实运行的结果是:
30 项检验(30 项成功)|与基线完全一致率 77%|平均路径重叠 0.85|基线路径保留率 92% 较稳健:23% 的扰动下组态结构变化,但基线路径平均仍有 92% 保留;建议在论文中报告稳健性矩阵并说明变化来源。
⑥ 报告:四种格式 + 一个能交给审稿人的脚本
- HTML 报告:图内嵌、可打印,适合附录;
- Word 报告:三线表格式,可直接改;
- Excel 工作簿:11 个工作表(校准 / 必要性 / 真值表 / 组态 / 三种解 / 路径统计 / 精确检验 / 校准后数据 / 稳健性 / 参数快照 / 解读文本);
- 可复现 R 脚本 ★:数据、锚点、阈值、方向性期望全部写死在代码里,任何人运行都得到完全一样的解(已对 4 套示例逐字验证)。
这一点是其他 GUI 软件最大的缺口:审稿人要“数据与代码”,你直接把脚本发过去就行。
换一套中文情境数据,结论同样干净
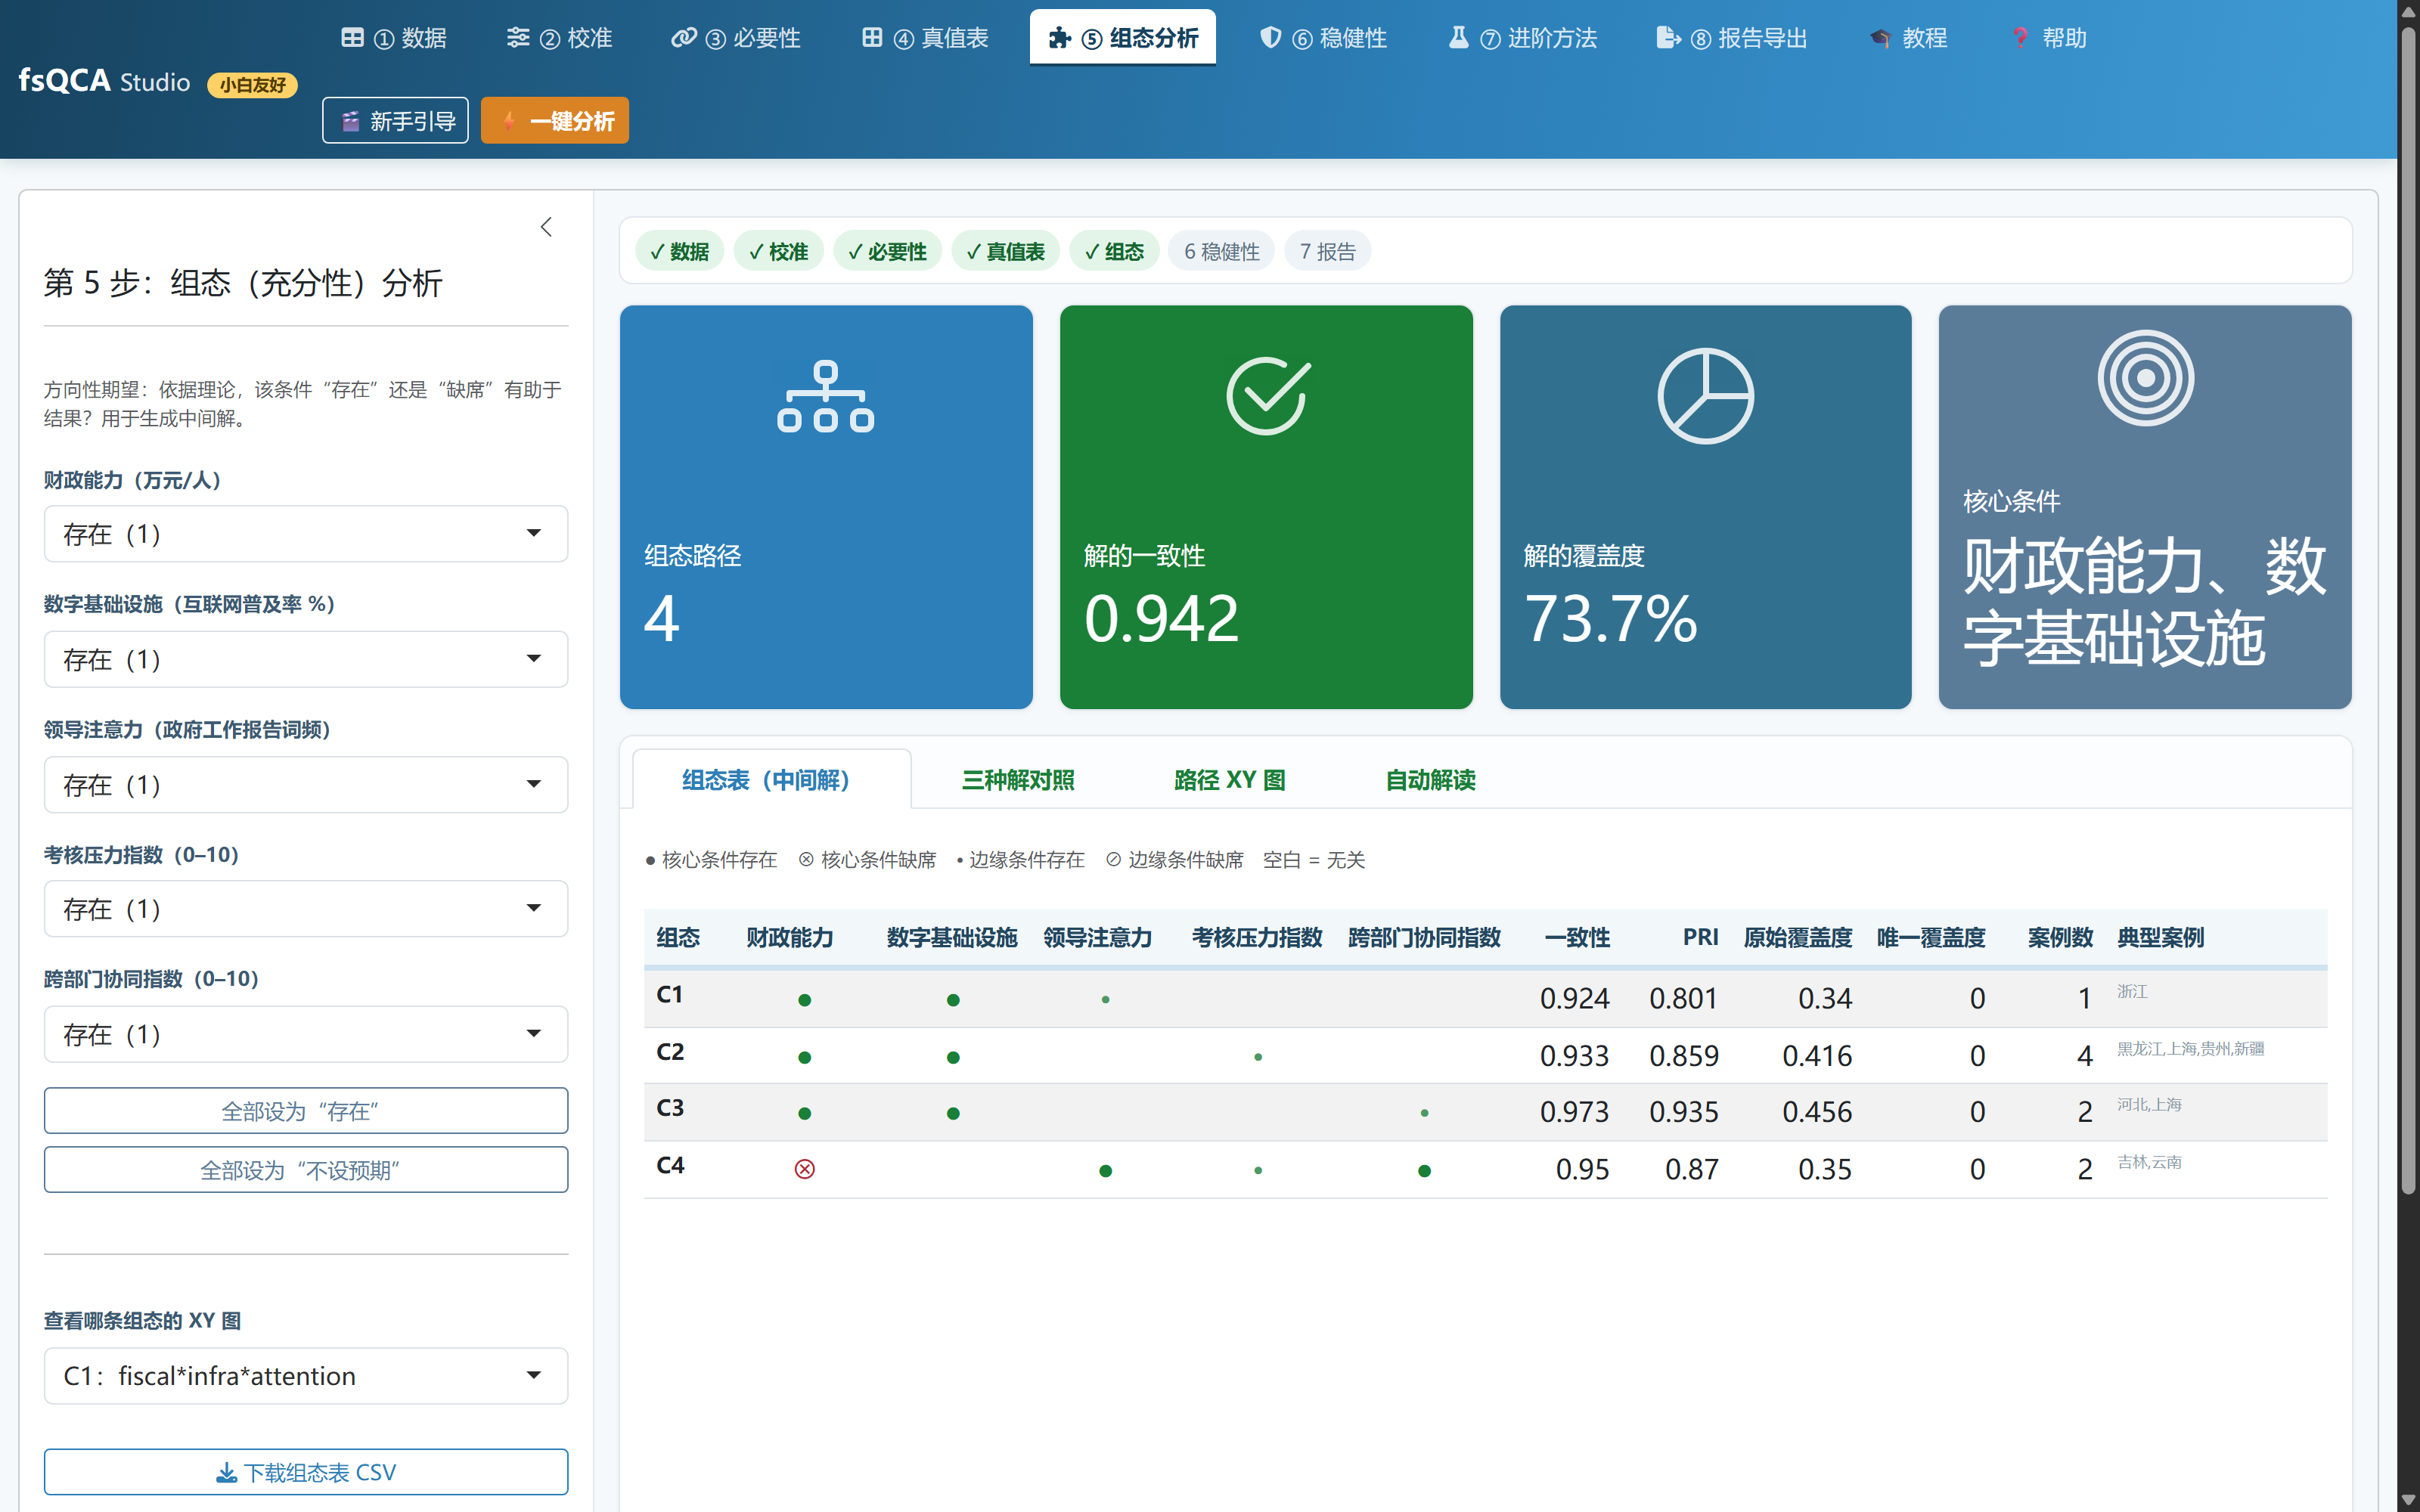
31 个省级行政区的数字政府建设绩效(条件:财政能力、数字基础设施、领导注意力、考核压力、跨部门协同)。
中间解给出 4 条路径,核心条件是财政能力与数字基础设施:
| 组态 | 表达式 | 一致性 | 原始覆盖度 | 典型案例 |
|---|---|---|---|---|
| C1 | fiscal × infra × attention | 0.924 | 0.340 | 浙江 |
| C2 | fiscal × infra × pressure | 0.933 | 0.416 | 黑龙江、上海、贵州、新疆 |
| C3 | fiscal × infra × coop | 0.973 | 0.456 | 河北、上海 |
| C4 | ~fiscal × attention × pressure × coop | 0.950 | 0.350 | 吉林、云南 |
解的一致性 0.942、覆盖度 73.7%。翻译成人话:“有钱 + 有底座”是主干,再叠加注意力、压力或协同中的任一项即可成事;而“没钱但注意力、压力、协同都到位”也是一条独立路径。
另外还内置了经典案例的对照:Lipset
民主稳定性(N=18) 复现出教科书里的中间解
DEV*URB*LIT*STB + DEV*LIT*~IND*STB——可以拿它验证软件的口径是否与
Ragin 原著一致。
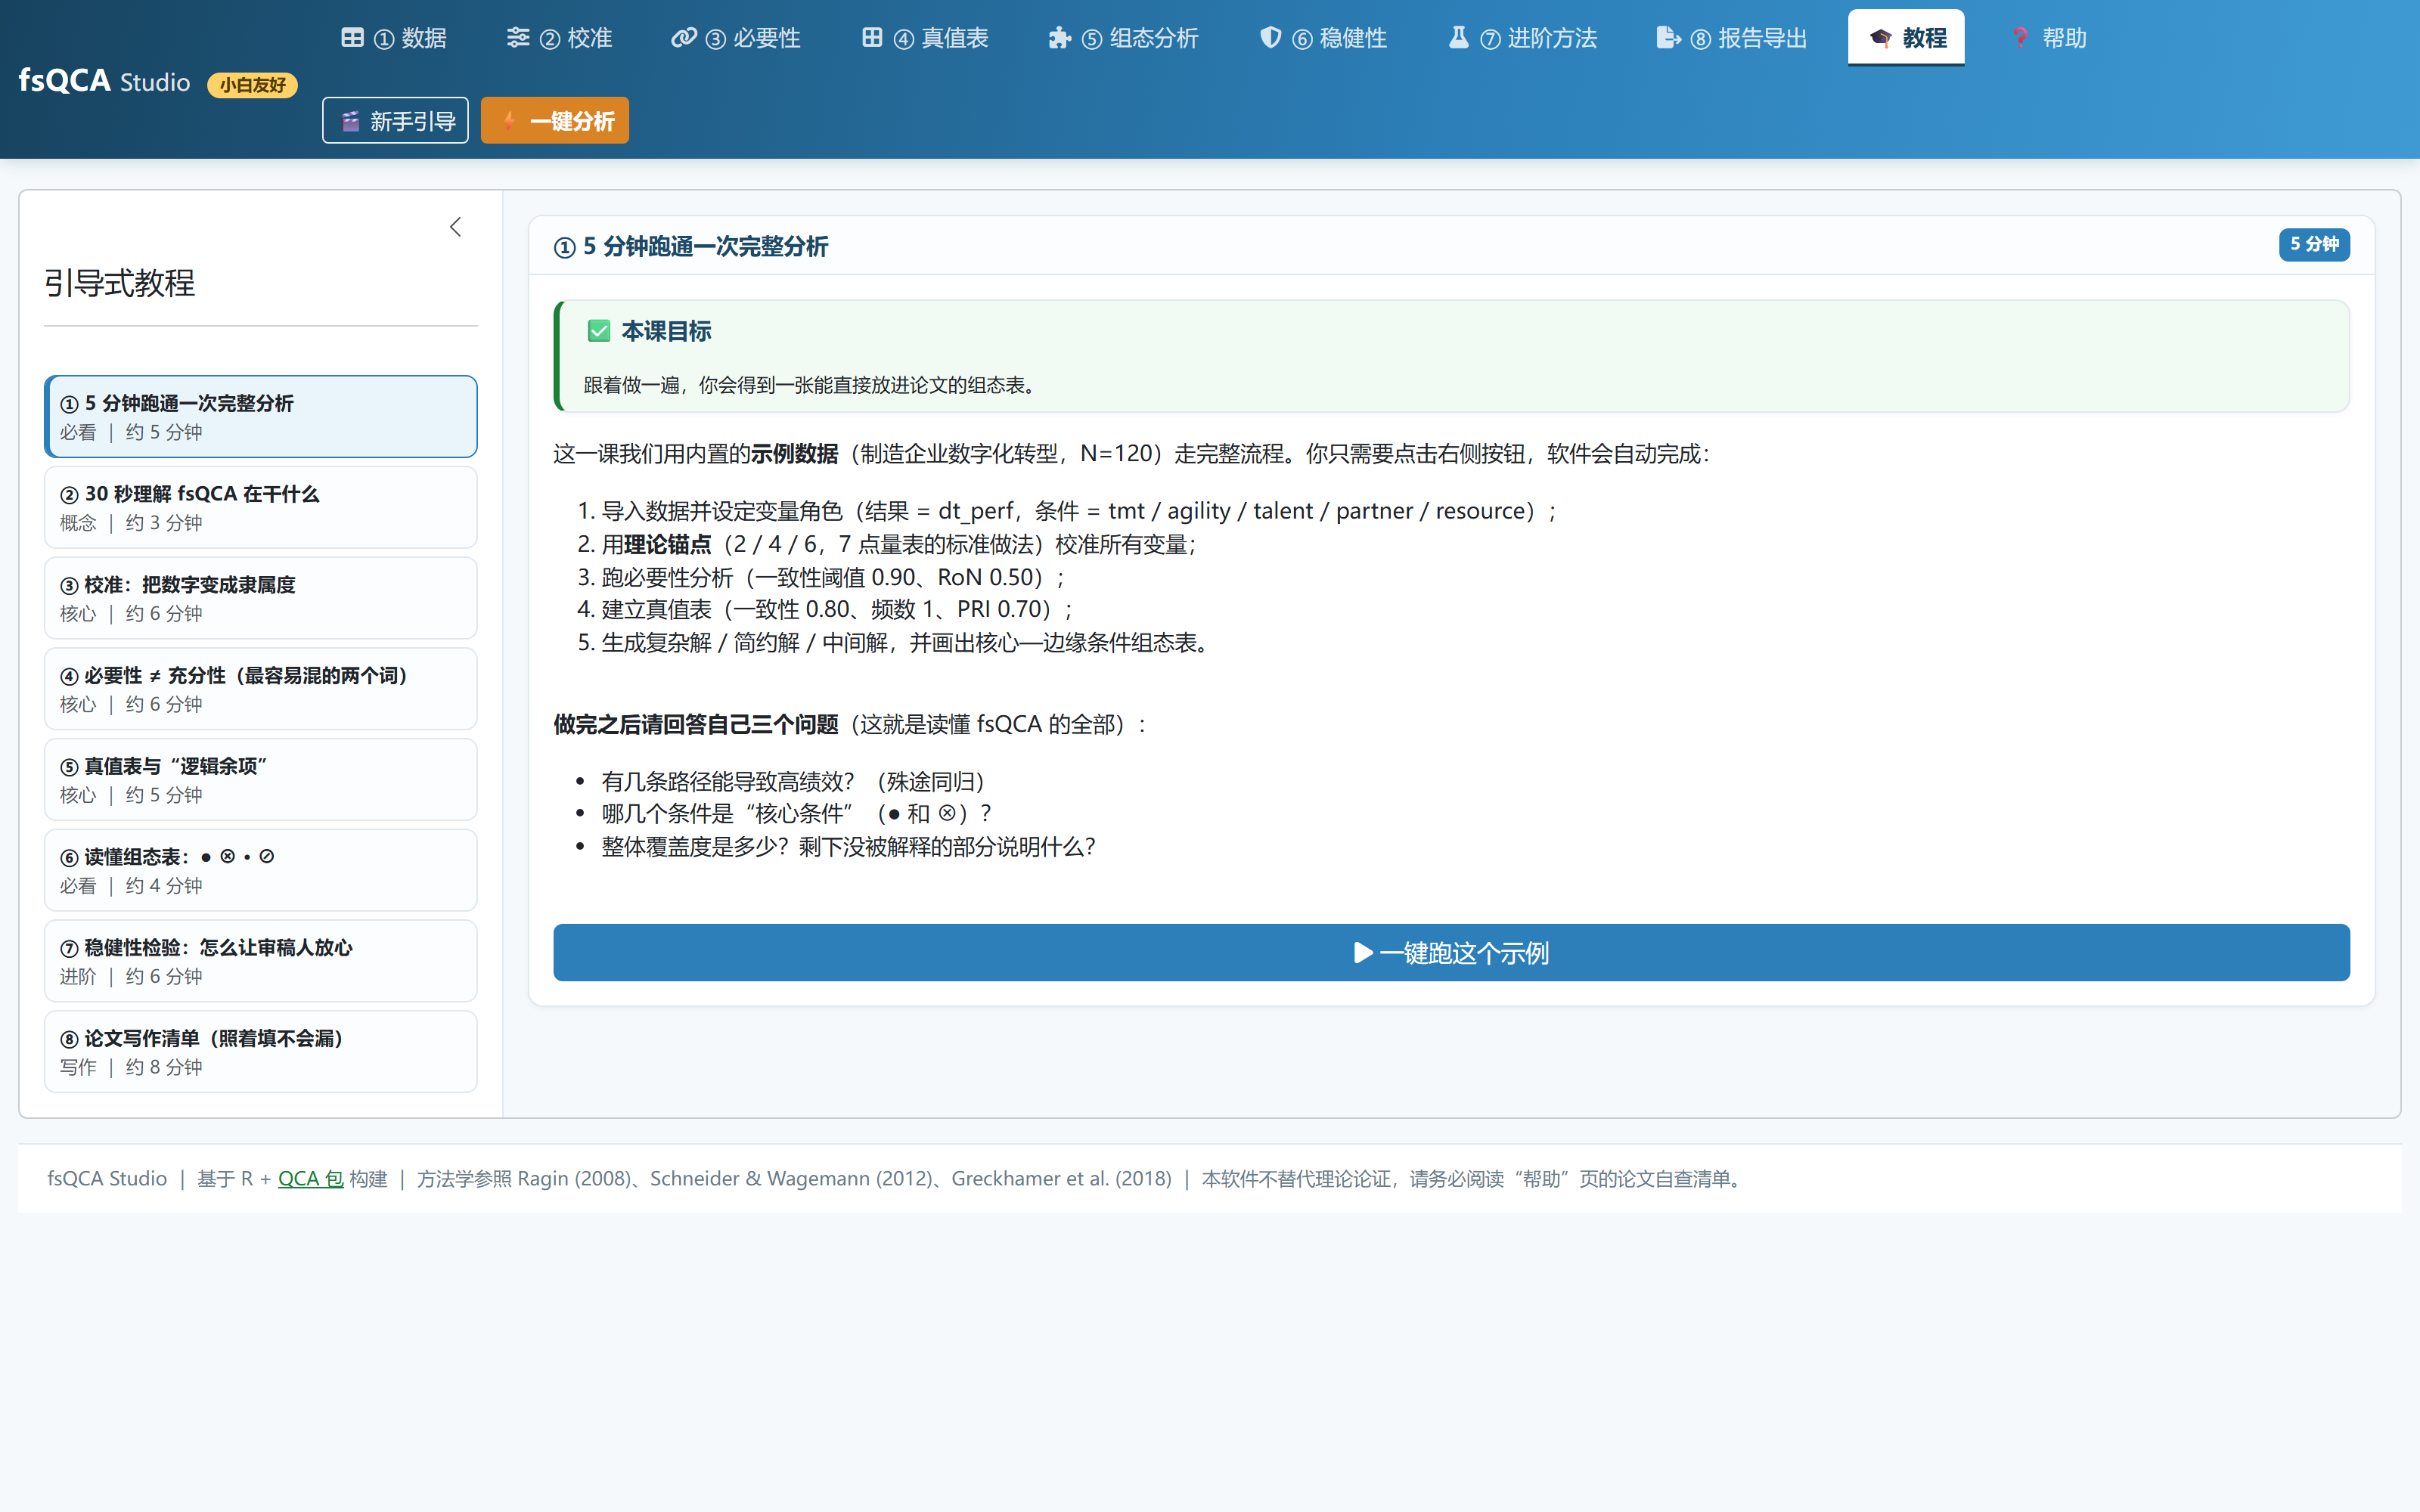
不会方法也能上手:8 节课 + 18 条术语 + 12 项自查清单
- 8 节引导教程:5 分钟跑通全流程 → 校准怎么定锚点 → 必要性与充分性的区别 → 真值表与逻辑余项 → 读懂组态表(● ⊗ • ⊘)→ 稳健性怎么做 → 论文写作清单;
- 术语速查(可搜索):一致性、覆盖度、PRI、RoN、核心/边缘条件、因果非对称、同时子集关系……
- 常见错误自查:8 条“现象 → 原因 → 怎么办”;
- 论文自查清单:12 项,照着打勾就不会漏报告项。
进阶方法也备好了
- 因果非对称(~Y):一键分析“导致低绩效”的组态,回答“那失败是因为什么”;
- 聚类 / 多层 QCA:按省份、行业、年份分层,同时给混合解、组间解、组内解;
- 理论评估检验:输入你预期的组态,软件告诉你它是否被经验证据支持。
谁适合用它
- 管理学、社会学、政治学、教育学方向,准备写第一篇 QCA 论文的研究生;
- 需要在论文里同时给出必要性 + 组态 + 稳健性 + ~Y 的完整证据链,又不想手写几百行 R 的人;
- 讲 QCA 方法的老师(内置示例 + 一键跑通,现成课堂演示);
- 会一点 R、想学 QCA 底层逻辑的人——软件导出的是真实
QCA包代码,可以直接读、直接改。
不需要你会写代码;但结果里给的全是可复现的 R 代码。
📮 获取 / 咨询 / 定制:微信 canglang12002(任公子)
加好友请备注「fsQCA」,方便优先通过。 提供一对一安装指导、按你的数据结构改造界面(例如加多值集 mvQCA、加两步 QCA 界面)等服务。
文中所有截图均来自软件真实运行界面;组态表数值、解的一致性/覆盖度、稳健性检验统计量均为真实输出(示例数据:制造企业数字化转型
N=120、省级数字政府 N=31)。核心算法调用 R QCA
包,中间解取自
minimize()$i.sol,与官方口径逐位核对一致。