TVP-VAR-SV:时变参数 VAR 模型的完整 Python 实现
TVP-VAR-SV:时变参数 VAR 模型的完整 Python 实现
一句话:把宏观与金融实证里最常用的 TVP-VAR-SV 模型——时变参数 + 随机波动率——做成一套开箱即用的 Python 实现:完整的贝叶斯 MCMC、时变溢出分解、脉冲响应,再配一个打开浏览器就能用的界面。
你大概遇到过这些
变量之间的传导关系,危机前后明显不一样,可模型里只有一个固定系数; 政策冲击的效果,十年前和现在不是一回事; 残差波动有明显的聚集,模型却假设它是常数。
这些正是 TVP-VAR-SV 要回答的问题——它在三个层次上都允许参数随时间变化。
但真动手时门槛不低:Gibbs 抽样要自己搭;Carter-Kohn 前向滤波后向抽样要自己写; 随机波动率不是线性高斯,得用混合正态去近似;链一旦不收敛,还很难定位原因。 好不容易跑通,时变溢出、脉冲响应、对冲比率又要自己从头算……
结果 80% 的时间花在实现上,只有 20% 在做研究。

模型:三处时变性
TVP-VAR-SV 的观测方程是
1 | y_t = X_t β_t + A_t⁻¹ Σ_t^{1/2} ε_t |
和普通 VAR 相比,它多了三个状态方程,把三样东西都设成随时间的随机游走:
| 状态 | 刻画什么 | 状态方程 |
|---|---|---|
| β_t | 时变系数——变量之间的传导关系 | β_t = β_{t-1} + u_t,u_t ~ N(0, Q) |
| a_t | 时变联立关系——同期冲击的相互影响 | a_t = a_{t-1} + v_t,v_t ~ N(0, S) |
| h_t | 随机波动率(h = log σ) | h_t = h_{t-1} + w_t,w_t ~ N(0, W) |
这是 Primiceri (2005) / Nakajima (2011) 的标准设定,也是宏观与金融实证里引用最多的版本。
为什么值得这么麻烦? 因为它把"参数不稳定"从一个需要做稳健性检验的麻烦, 变成了模型本身就能刻画的对象——你可以直接把系数路径和波动率路径画出来, 看清它在哪一年、因为什么事件发生了变化。

实现难在哪
真正写过的人才知道,难点集中在三处:
① 状态维度高。 β 的维度是
n(np+1)——三个变量、两阶滞后就是 21 维,
而且每一期都要抽一次。这是典型的"高维状态空间 +
时间维"问题, 朴素做法在数值上非常脆弱。
② 随机波动率不是线性高斯。 把 log(ε²)
展开会得到 log(ε²) = 2h + log(χ²₁),最后那一项不是正态的,
所以状态空间方法不能直接用——必须用混合正态去近似它。
③ 弱识别。 系数游走方差 Q 和波动率
σ 会相互替代: Q
一大,系数就能自己漂移着把数据的异方差"吸收"掉, 于是抽样器把
σ
压向零。似然几乎不惩罚这件事,只有先验能约束它。
这三点如果没处理好,表现是看起来跑完了、结果却不对——比直接报错更难发现。

Python 实现
整套模型实现为一个独立的 Python 包,不依赖任何商业软件:
抽样框架——Primiceri / Nakajima 的传统做法,逐块共轭更新:
| 模块 | 方法 |
|---|---|
时变系数 β_t、联立关系 a_t |
Carter-Kohn 前向滤波后向抽样(FFBS) |
随机波动率 h_t |
Kim-Shephard-Chib 混合抽样 + FFBS |
Q / S |
逆 Wishart(Bartlett 分解) |
W |
逆 Gamma |
实现过程中解决了几个容易被忽略的坑,这里挑两个说:
KSC 混合表的均值是错的。 文献里广为流传的那张 7 分量混合参数表, 隐含均值恰好为 0;但
log(χ²₁)的真均值是ψ(1/2) + log 2 = −1.2704。 用错均值不只是导致偏移,更糟的是制造伪不动点——各分量均值相距很远, 起点稍偏就会锁死在错误分量上,波动率路径再也走不动。 这里用 EM 重新拟合了这张表(均值 −1.2726、方差 4.9466,与理论值一致)。
Q的先验必须真的起作用。 逆 Wishart 先验的影响力通过尺度矩阵而非自由度体现, 后验自由度约为q_df + T − 1,尺度设小了先验形同虚设。 这里按 Primiceri 的做法把Q锚定在 OLS 系数的抽样方差上, 并在模型自模拟数据上做了标定扫描。


验证:不看图"像不像",看数字
模型类代码最怕"跑出来了但不对"。这里的做法是把每个模块单独拎出来验证:
- FFBS 单独验证——用已知的随机游走状态生成观测,看能否复原: 后验路径与真值的相关性 0.995;
- 随机波动率分块单独验证——固定真实残差只跑 SV 那一块, 收敛到真值(比值 0.92–1.10),说明 SV 模块本身没有偏差;
- 模型自模拟数据验证——从模型本身生成数据再估计:
σ恢复比 0.92、路径相关性 0.78; - 115 项单元测试覆盖全部函数。
1 | FFBS 后验 vs 真值 相关性 0.995 |

一个验证陷阱,值得单独说
做逐位一致性验证时,报告一直显示"约一半的正态随机数差 1 ULP"。 这个比例很可疑,我一度以为抽样表写错了,还专门写了求解器去反解……
结果是:表本来就是对的。 真正的问题在这里:
1 | float('-0.94724664395737113') # -> -0.9472466439573711 正确 |
pandas.read_csv 的默认解析器对浮点文本会有 1 ULP
误差。
用它读参考值去做逐位检验,会让正确的实现看起来是错的。
改一个参数就解决了:pd.read_csv(..., float_precision="round_trip")。
写在这里是因为——做数值工作的人迟早会踩到,而它会伪装成你自己的
bug。
可复现性:随机数流逐位可控
随机数是科学计算里最容易被忽视的可复现性来源:抽样器实现差一点,MCMC 结果就完全不同。
这套实现把随机数流做到了逐位可控——同一个种子,在任何机器上跑出来的结果完全一致。
正态抽样用的是 256 层 Ziggurat 拒绝采样(Marsaglia
& Tsang, 2000), 实测每次尝试恰好消耗 2 个 32 位字、约
2.13% 被拒绝;
正因为拒绝路径也是逐位一致的,rand / randn /
randi 三者交错调用后流位置依然对齐。
配套的验证框架在 320 万个取值上做了零失配检查。
界面:不写代码也能跑完全流程
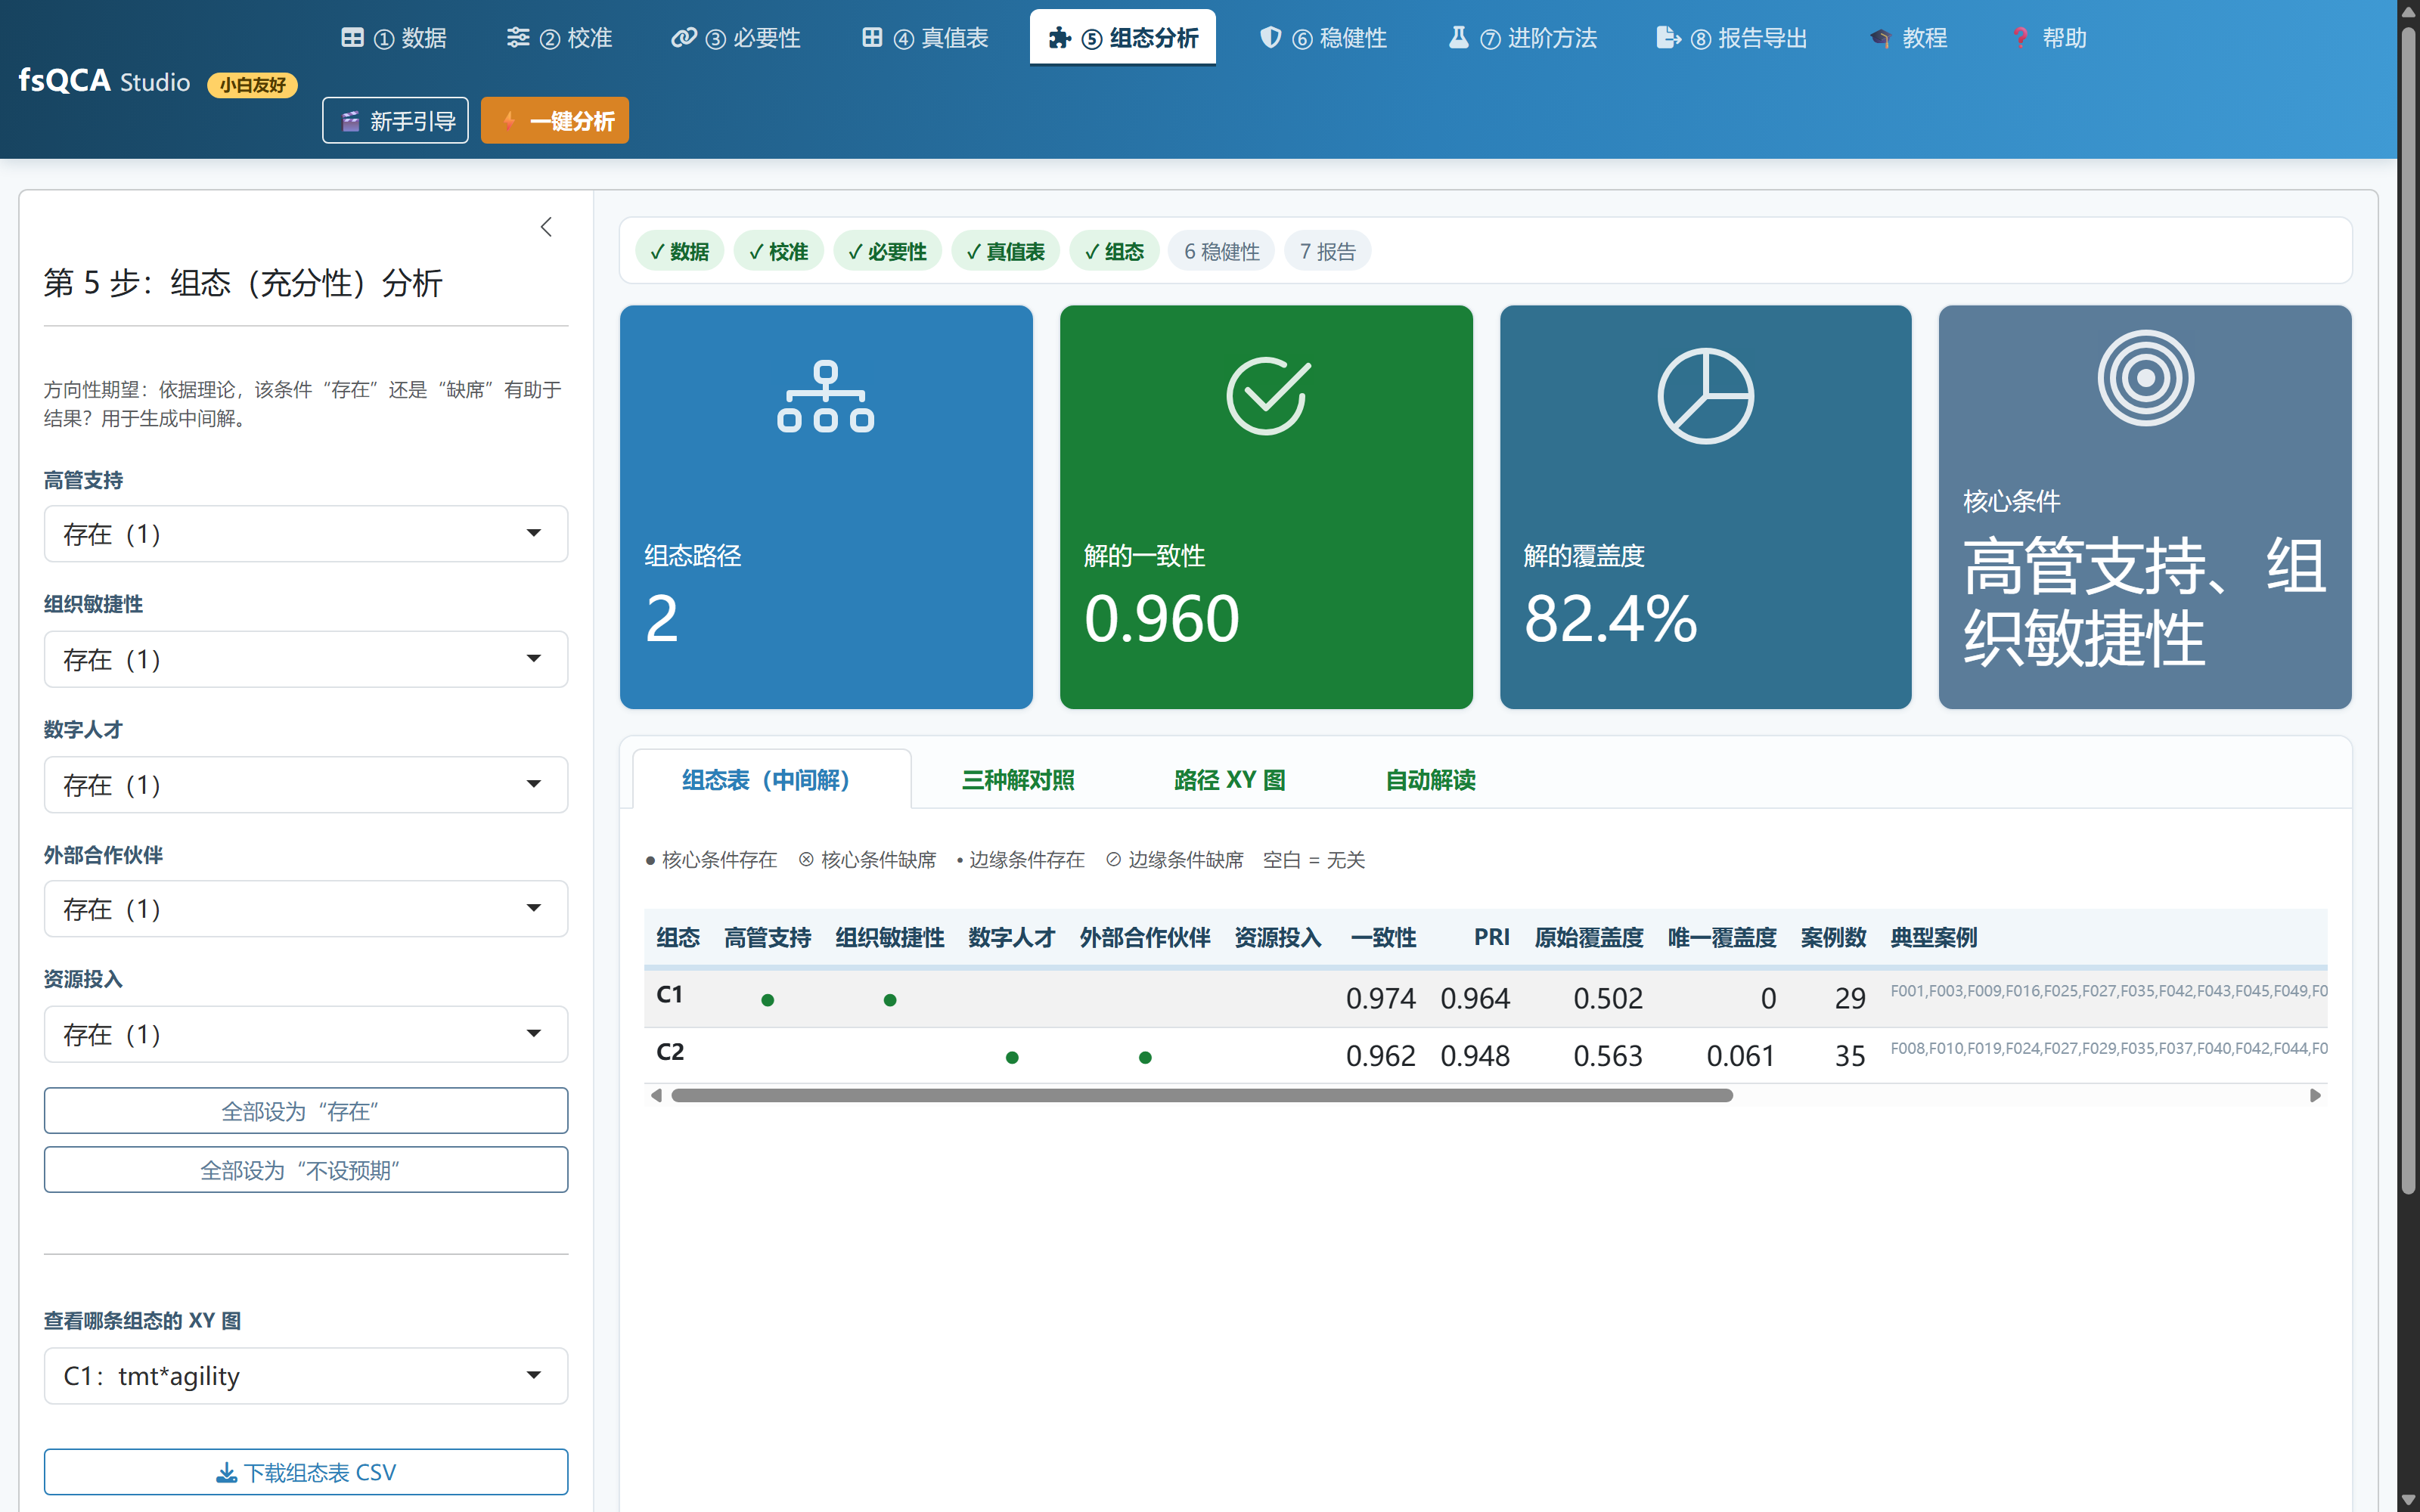
除了当库用,还配了一个本地 Web 工作台——打开浏览器就能用, 不需要联网(图表库已本地化打包)。11 个功能页:
数据 → 描述统计 → 单位根检验 → 溢出分析 → 净溢出 → 滚动窗口 → TVP-VAR-SV 估计 → 脉冲响应 → 对冲分析 → 论文版式图 → 数值验证

每一步都能看到原始数值,也都能导出——不是黑箱。

除了估计,还能直接得到什么
TVP-VAR-SV 的价值不止在系数本身,配套的几样分析这里都做好了:
- 波动率溢出分解——广义预测误差方差分解(Diebold-Yilmaz), 含总溢出指数与方向性溢出;
- 时变溢出——每个时点的溢出结构,看传导关系如何演化;
- 脉冲响应——含常数项 VAR 的 Cholesky 正交化响应;
- 对冲与组合——动态对冲比率、最优权重、对冲有效性;
- 单位根检验——ADF-GLS(Elliott-Rothenberg-Stock)。


适合谁
- 做 宏观 / 金融时变特征实证的研究生与青年教师;
- 需要波动率溢出、有连接性分析的课题组成员;
- 想快速试一个模型、不想先折腾两周环境的分析师;
- 教书时需要一个能当场演示、不用配环境的工具。
数据格式很宽松:首列是日期、其余是数值序列即可,CSV / Excel 都能直接导入。
最后
整个项目已经整理好:完整的模型实现 + 11 页操作界面 + 验证与测试框架, 115 项单元测试、320 万取值零失配检查全部通过。
如果你正在做时变参数、随机波动率或溢出分析,应该能直接省下不少时间。
📮 需要的加我微信:canglang12002(任公子),备注「TVP-VAR」优先通过。
本文由项目自带的发布脚本生成。所有数据、接口与结论均可在本地复现;生成时间:2026-09-26 22:56:53。